Thinking
Summary
Timestral, la prima famiglia di modelli foundation per serie temporali di Mistral, offre previsioni probabilistiche multivariate all'avanguardia con soli 209M di parametri, superando modelli più grandi nei benchmark chiave e supportando al contempo covariate passate e future. Disponibile in quattro dimensioni (da 5M a 209M parametri), bilancia accuratezza e efficienza, funzionando in modo efficiente su CPU e eccellendo nelle previsioni zero-shot per domini diversi. Il modello combina pre addestramento sintetico, attenzione consapevole delle covariate e apprendimento a contesto lungo, con opzioni di fine-tuning per l'adattamento al dominio tramite Mistral Forge.
Oggi rilasciamo Timestral, la nostra prima famiglia di modelli di fondazione per serie temporali. Il nostro modello più grande, con appena 209M parametri, si classifica al primo posto in tutti e tre i principali benchmark pubblici del settore, GIFT-Eval, TIME e fev-bench, superando lo stato dell'arte precedente con soli due terzi dei parametri.
Timestral offre previsioni probabilistiche multivariate e supporta covariate solo-passate e a futuro noto. La nostra famiglia di modelli si colloca sul fronte di Pareto tra accuratezza di previsione e dimensioni del modello, garantendo prestazioni al vertice per ogni taglia. I risultati sono stati sottoposti alle classifiche GIFT-Eval e TIME.
Modelli di fondazione per serie temporali (TSFM)
Le serie temporali sono uno dei tipi di dati più comuni in ambito aziendale, dalla telemetria dei sensori alle metriche di osservabilità. Le previsioni basate su di esse orientano le decisioni in materia di pianificazione della capacità, energia, catene di fornitura, rischio e manutenzione.
Gli impianti industriali prevedono i valori dei sensori di processo in funzione del programma di produzione, intercettano la deriva delle apparecchiature prima che si guastino e pianificano capacità e ricambi su migliaia di asset. I team finanziari prevedono flussi, volumi e volatilità per orientare posizioni, coperture e tesoreria su migliaia di conti.
I modelli classici come ARIMA e la regressione lineare restano strumenti consolidati per la previsione di serie temporali. Questi modelli vengono in genere adattati a una singola serie e apprendono solo dalla storia di quella serie.
I modelli di deep learning come PatchTST aggiungono la capacità di apprendere pattern non lineari attraverso molte serie correlate, ma vengono in genere ancora addestrati da zero su ciascun set di dati, quindi ciò che apprendono non si trasferisce a nuovi domini.
I modelli di fondazione per serie temporali portano l'approccio del pre addestramento a questo tipo di dati. Addestrato su un corpus ampio e diversificato, il nostro modello apprende pattern che si trasferiscono tra serie diverse, effettuando previsioni zero-shot su dati mai visti, anche in domini in cui i dati sono scarsi.
Risultati dei benchmark
Abbiamo valutato Timestral sui tre principali benchmark pubblici di previsione: GIFT-Eval, TIME e fev-bench. Tra i modelli pre addestrati e zero-shot, si classifica al primo posto in tutte e cinque le metriche. Questi risultati derivano da un singolo checkpoint, senza ricorso a ensemble.
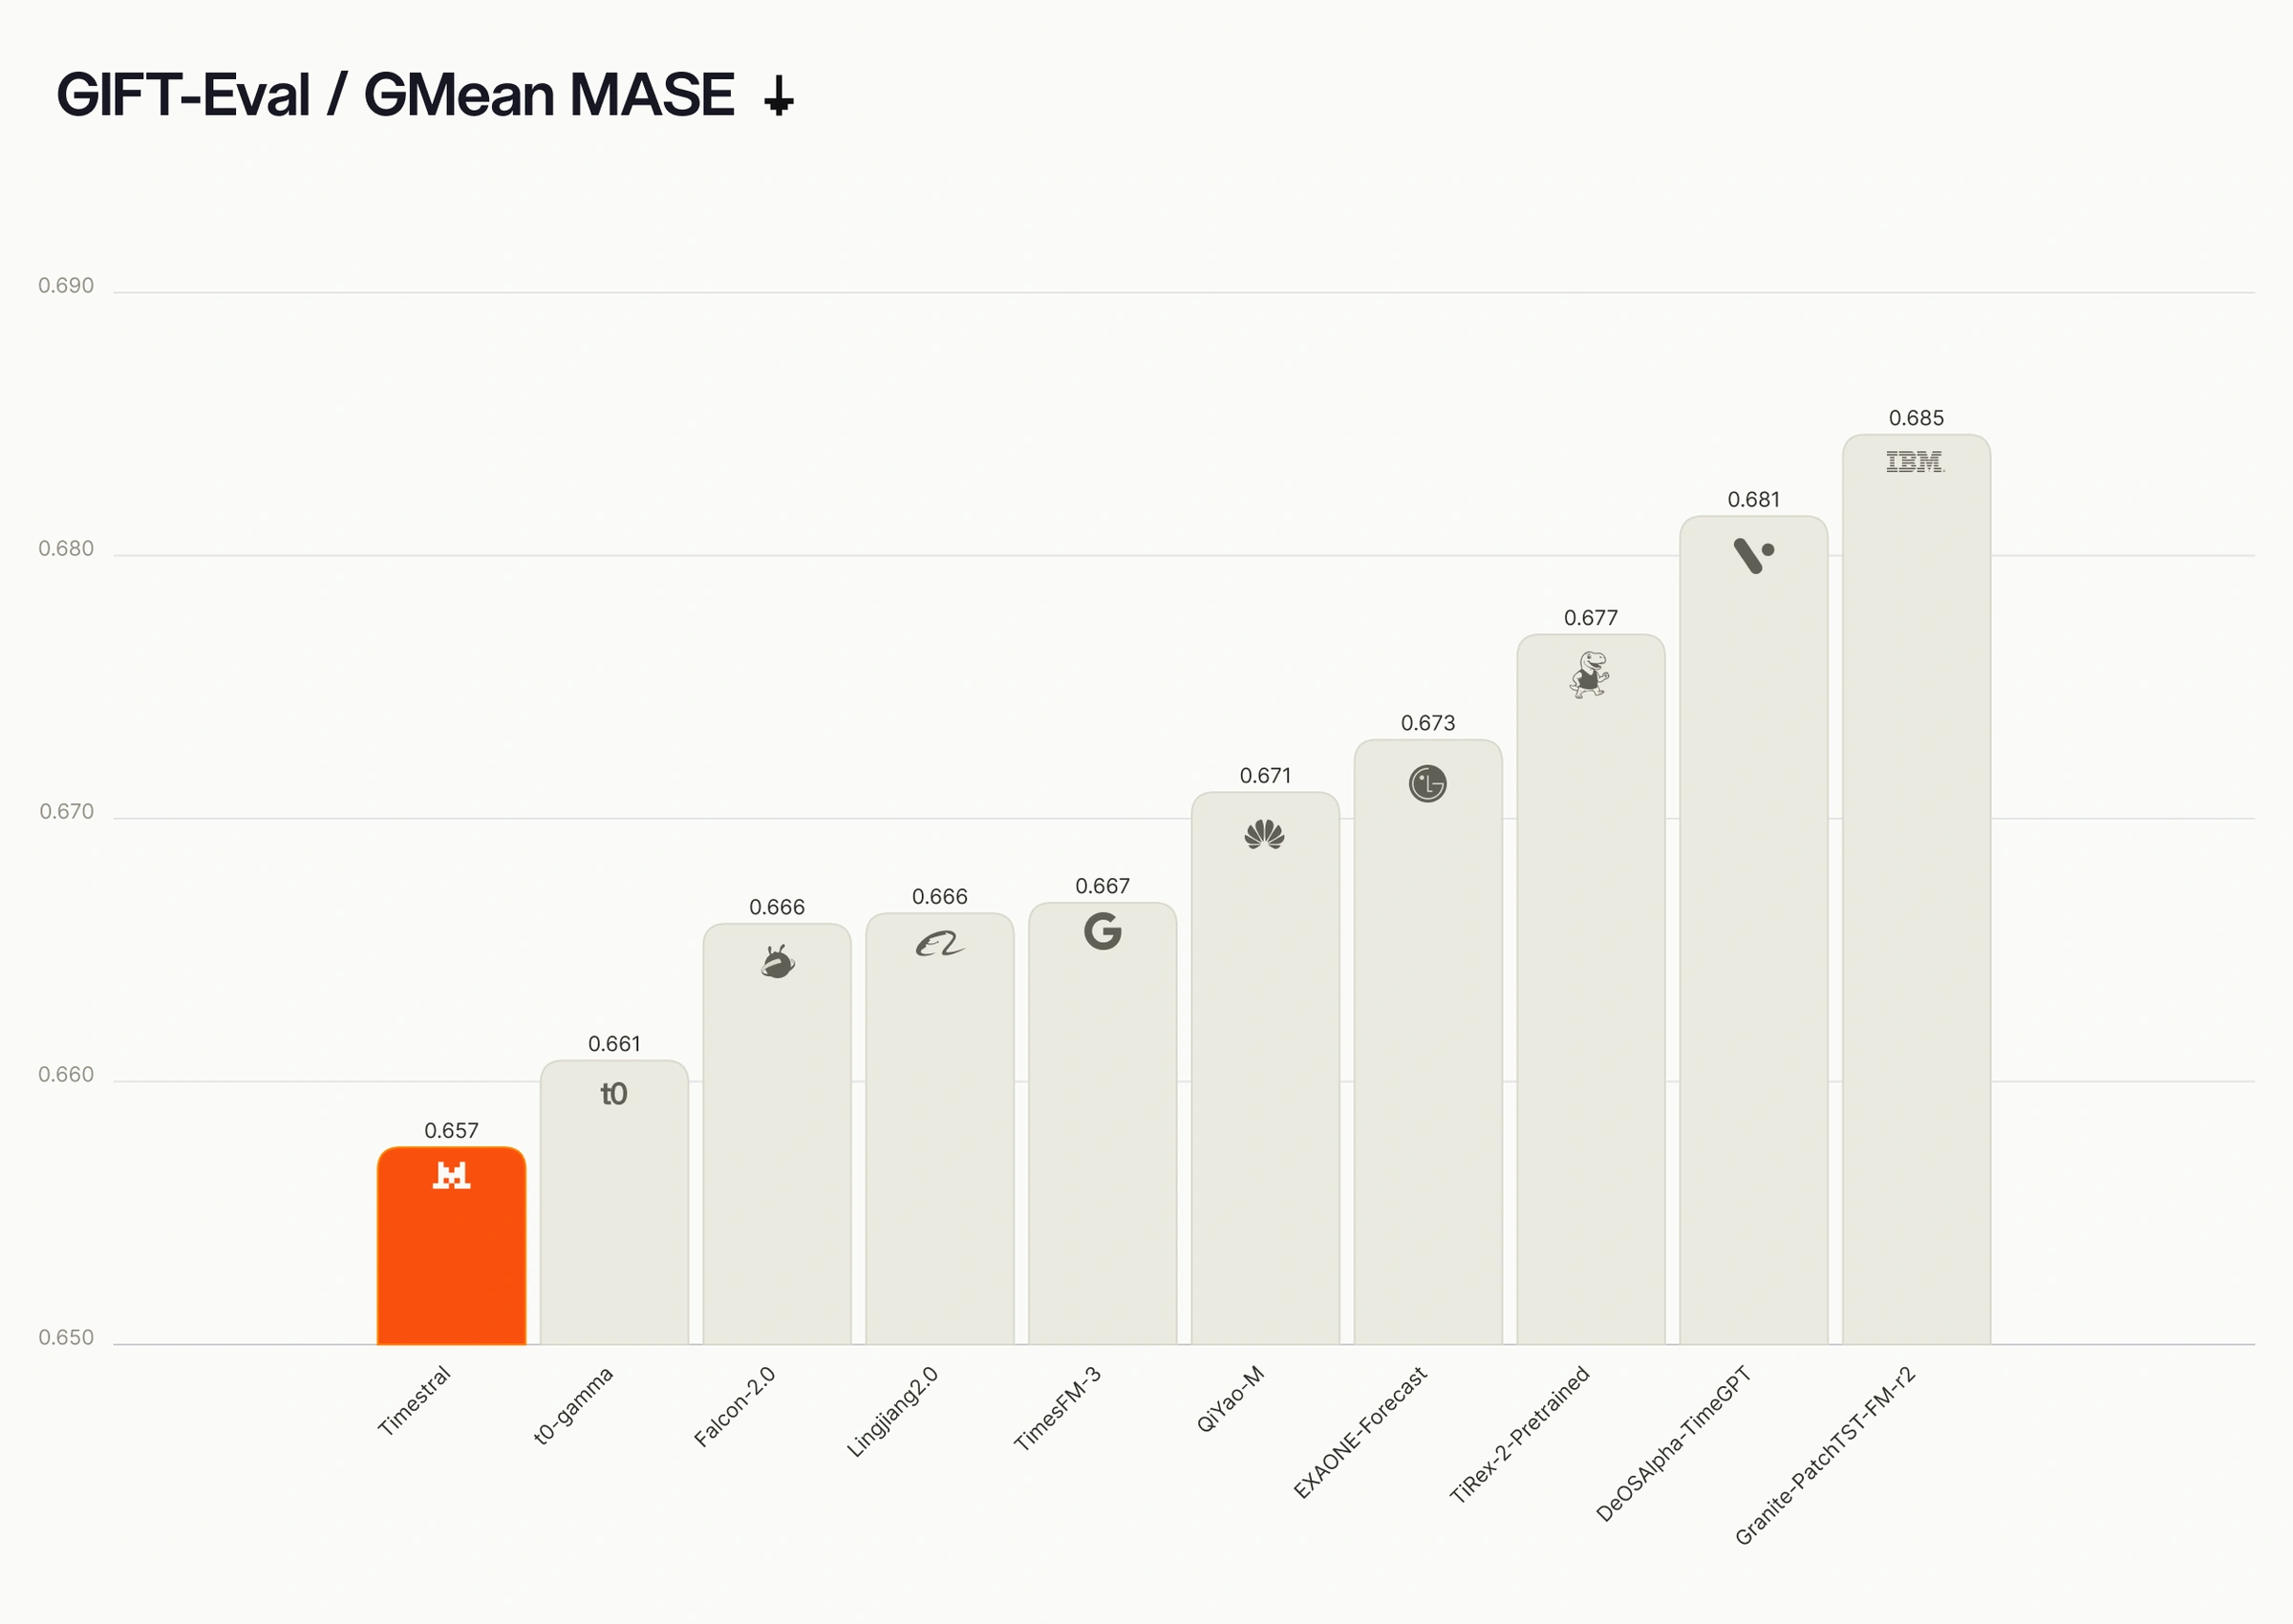
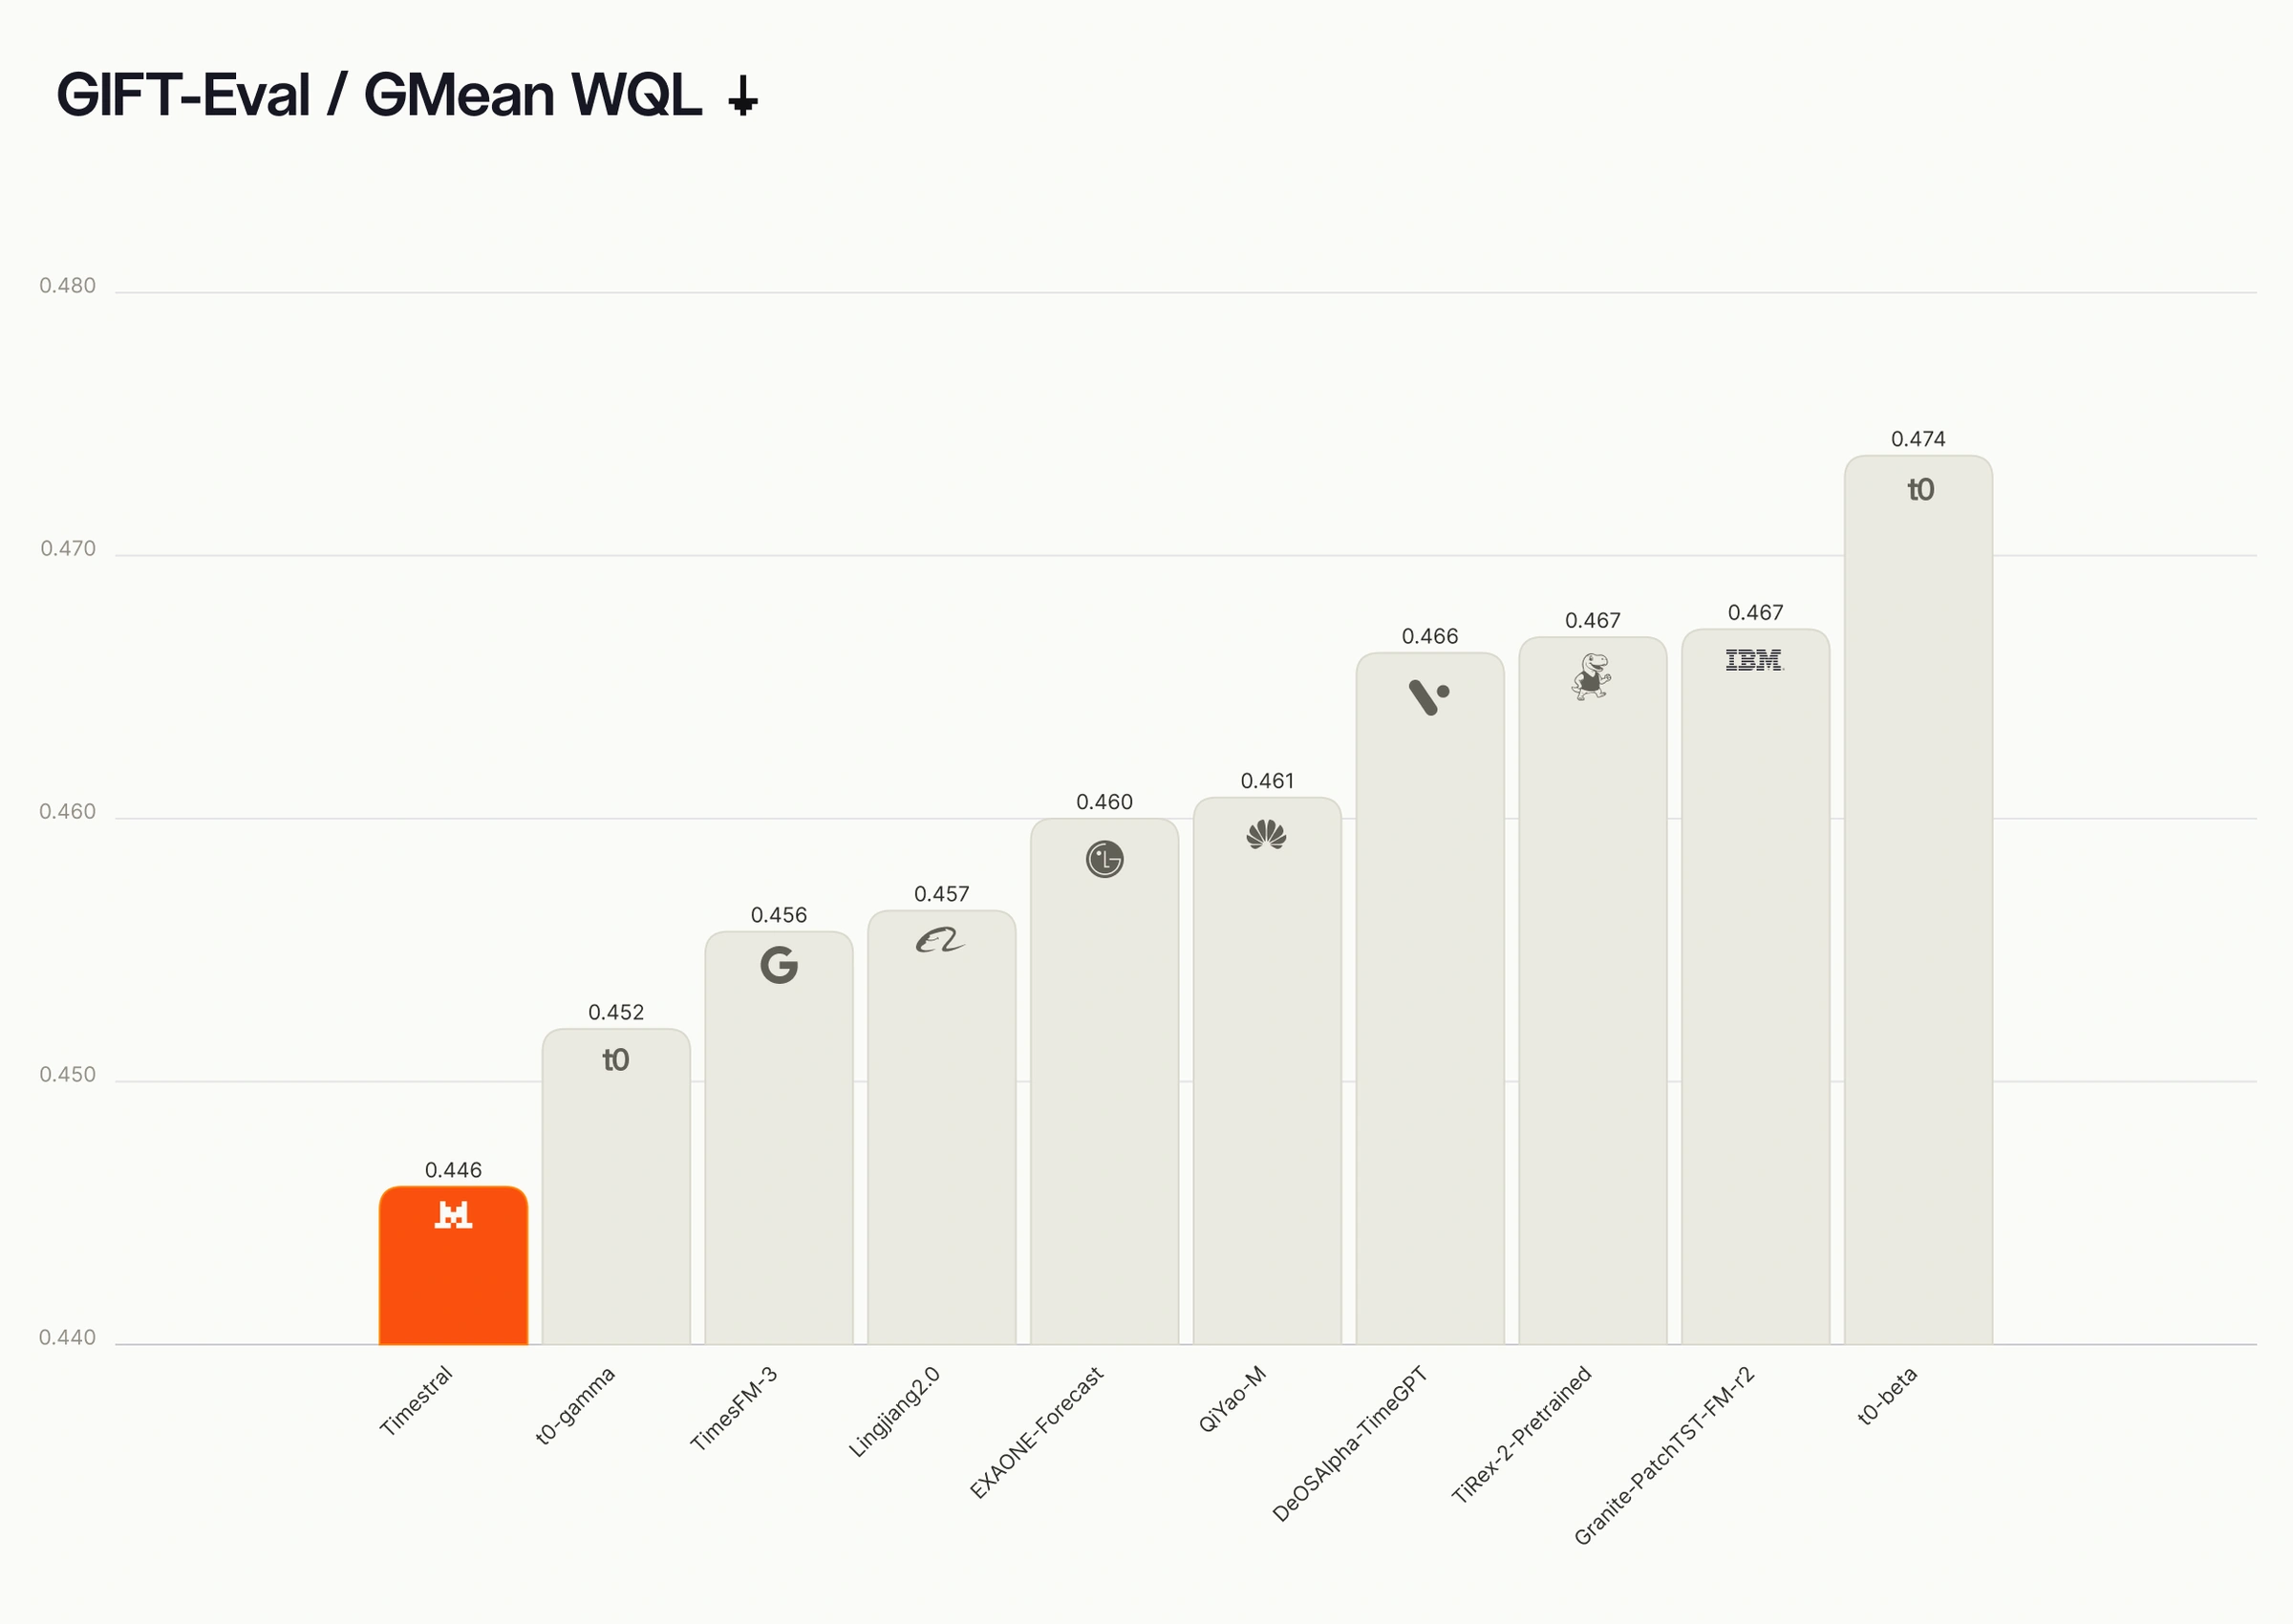
GIFT-Eval, prime dieci posizioni su 83 voci comparabili pre addestrate e zero-shot. Valori più bassi sono migliori.
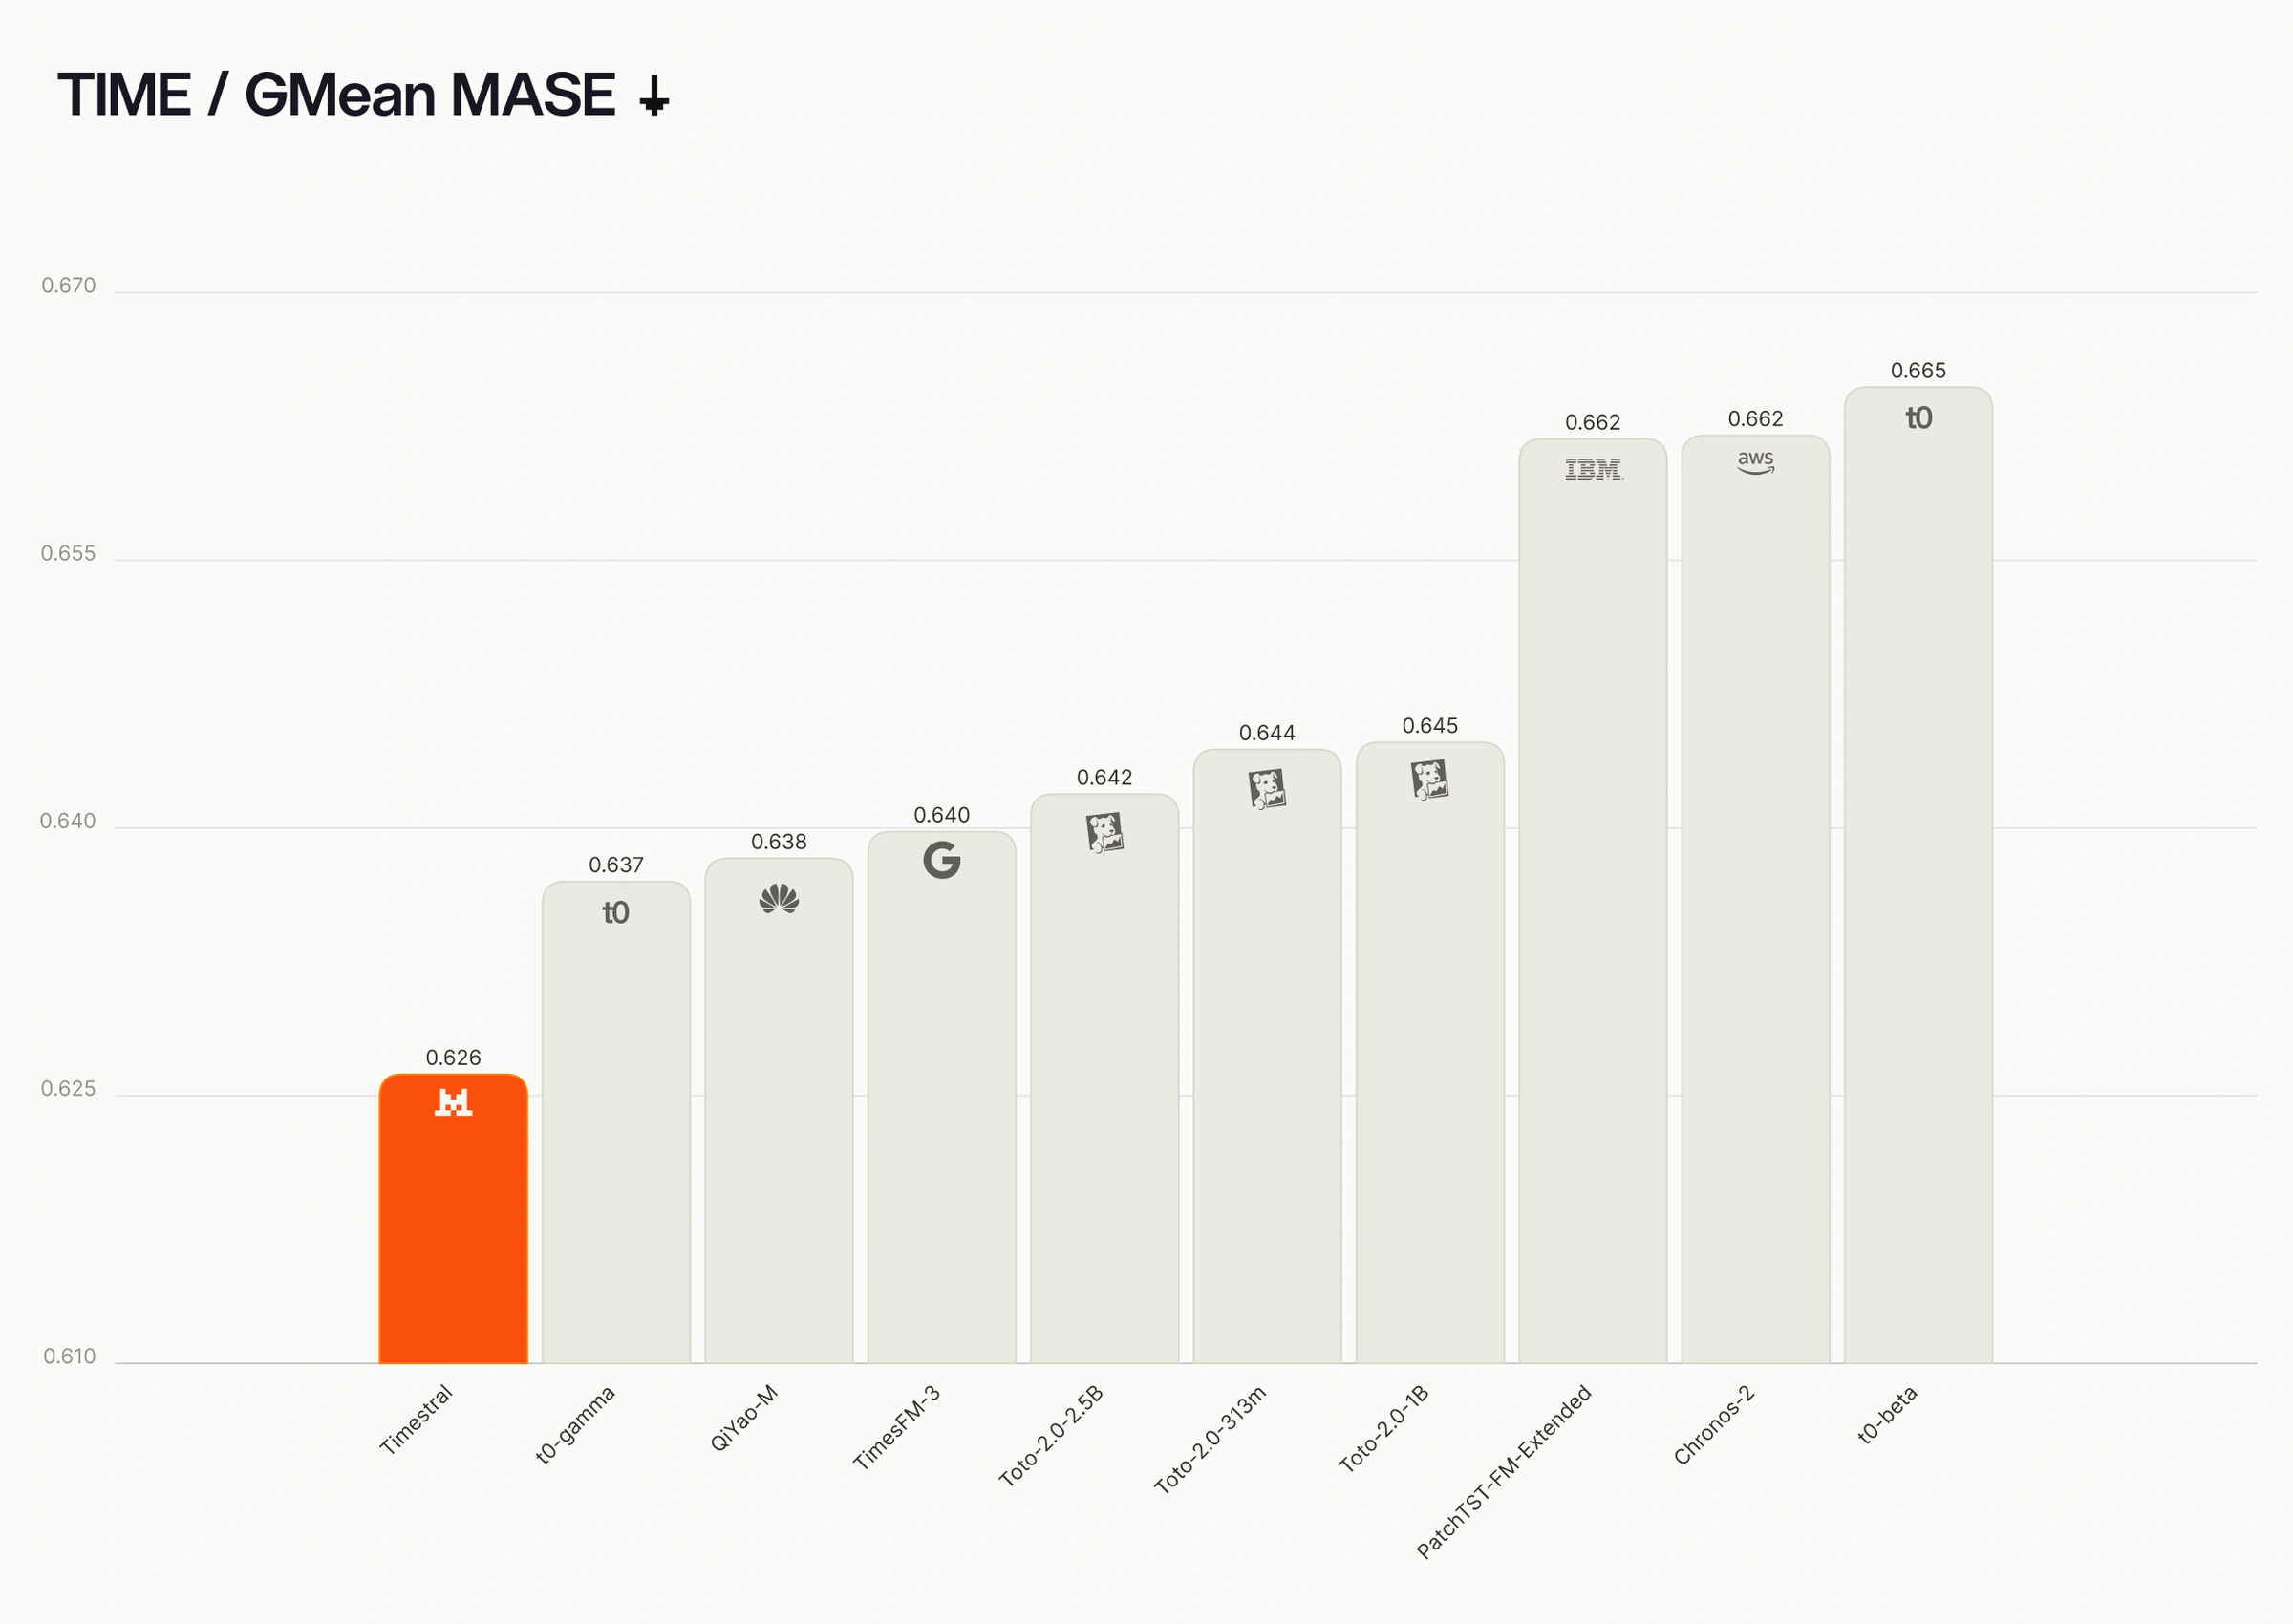
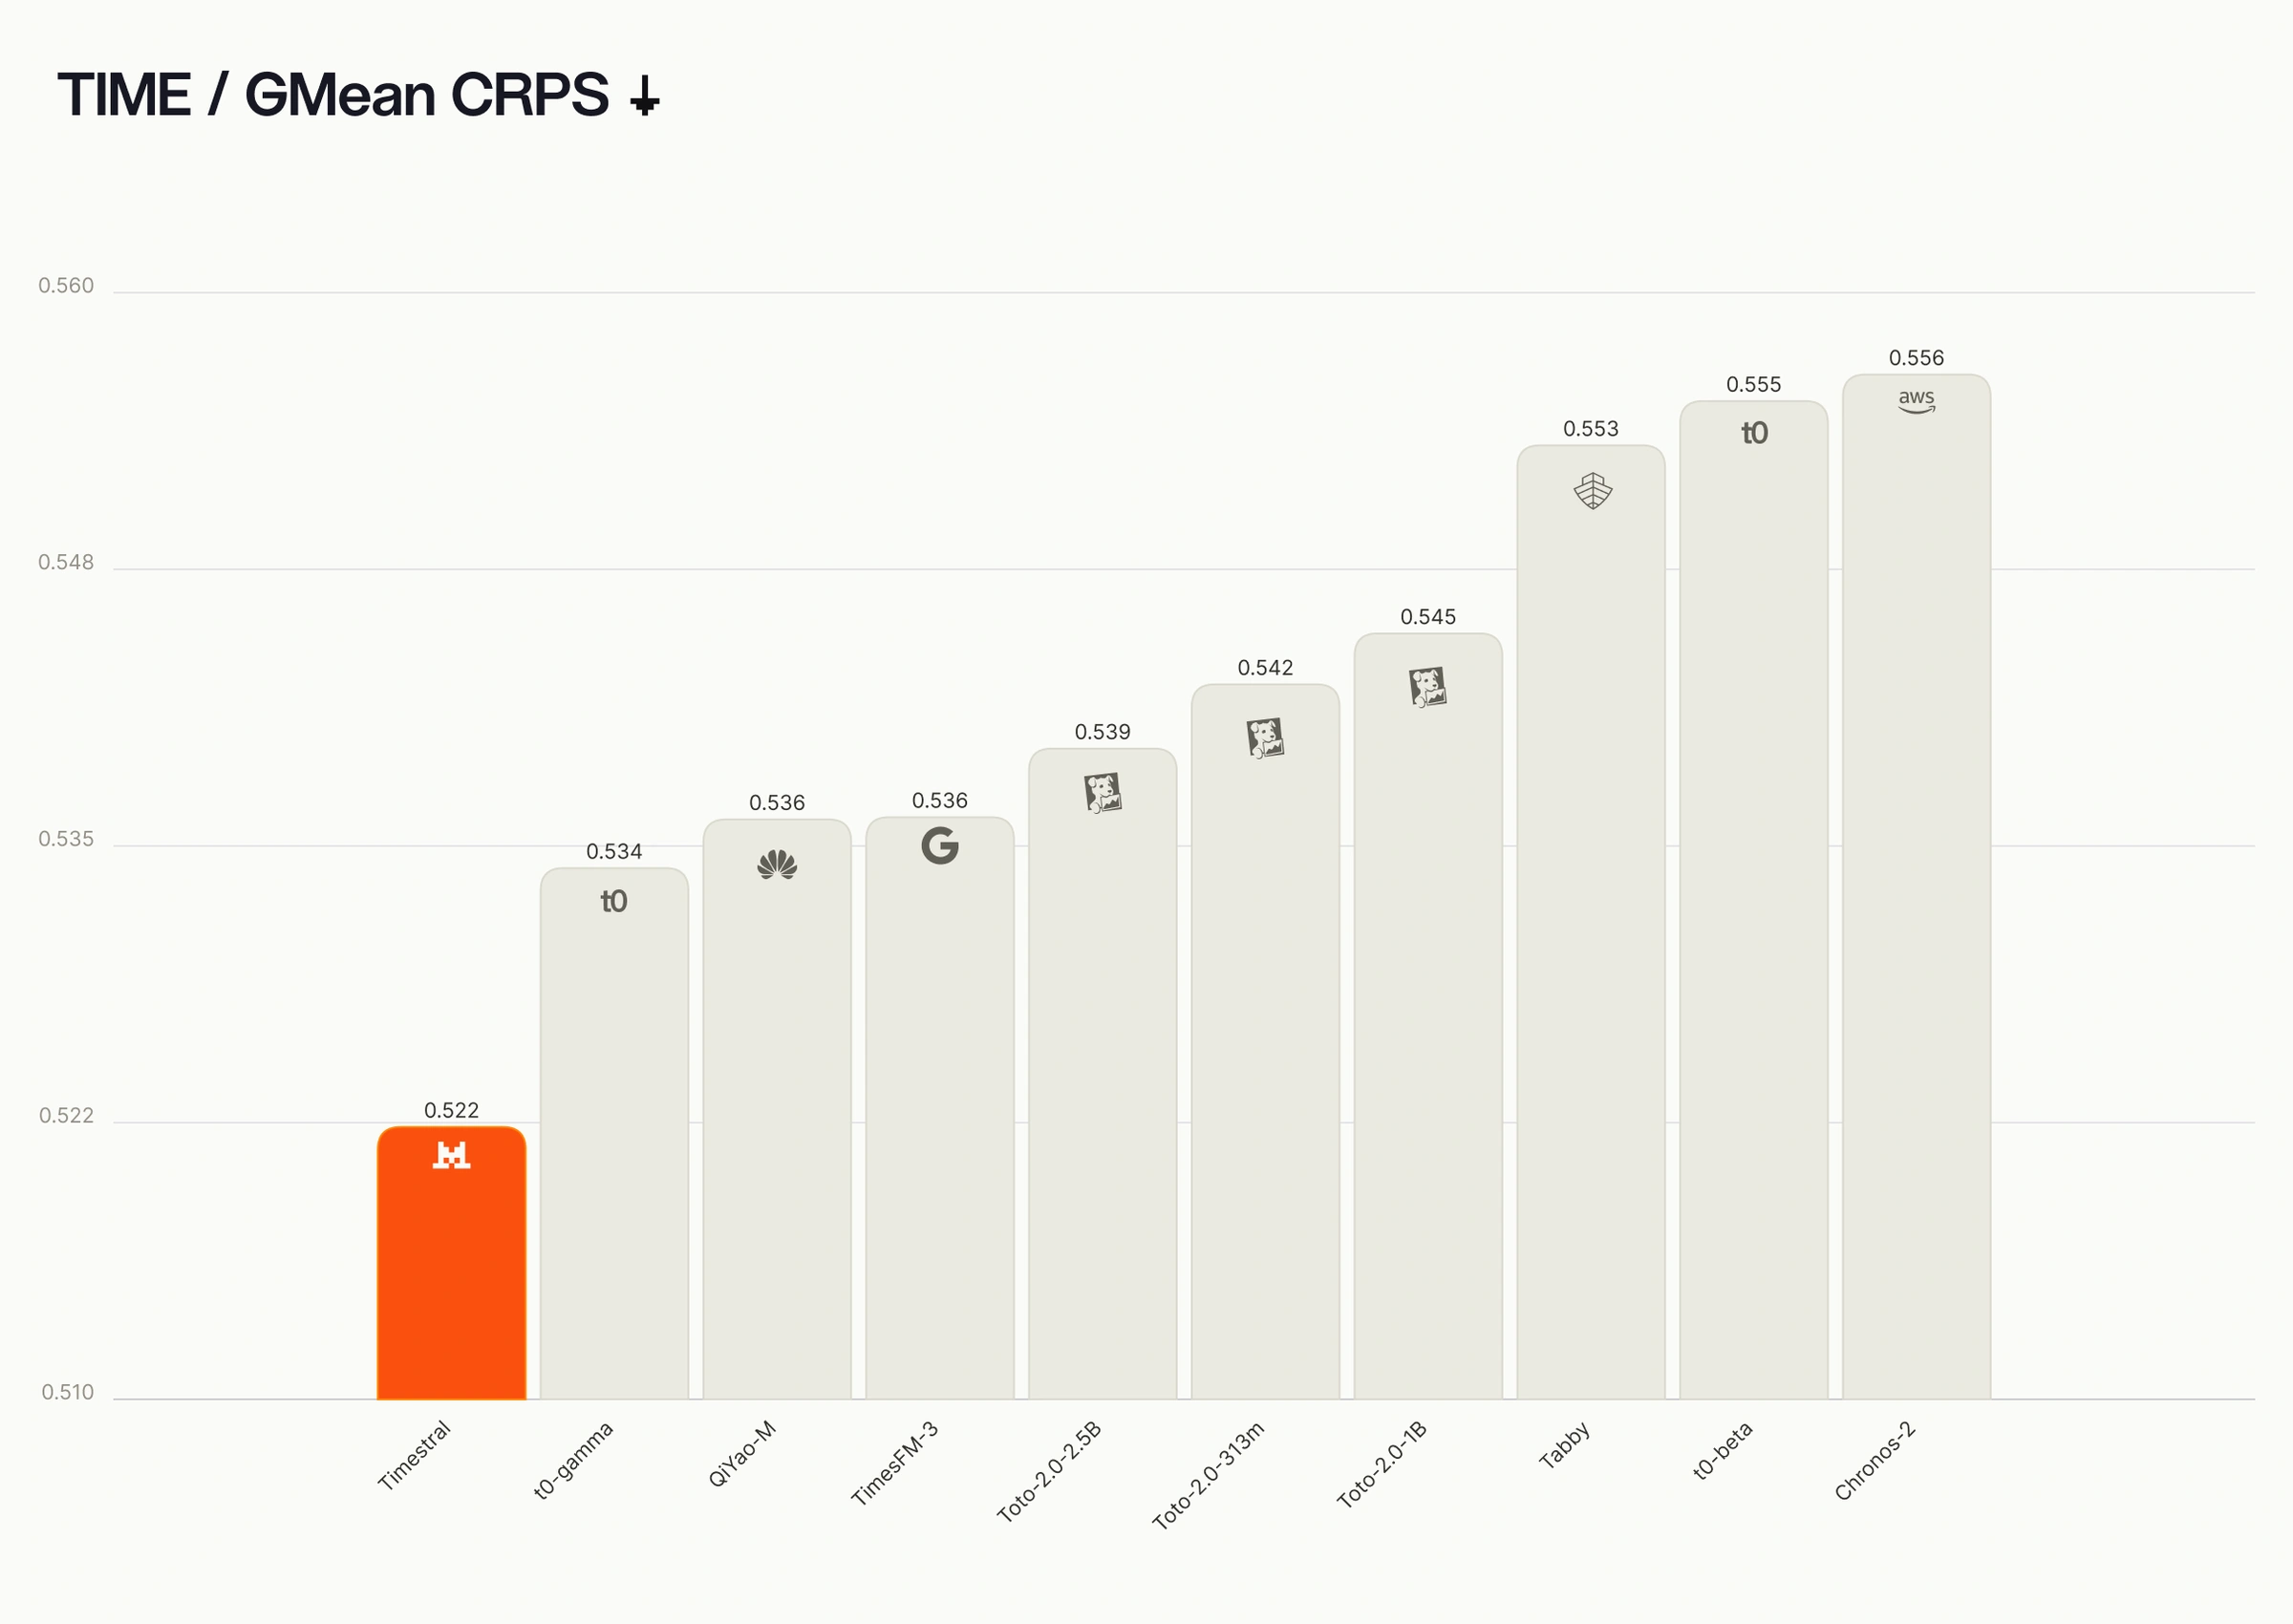
TIME, prime dieci posizioni delle 35 voci in classifica. Valori più bassi sono migliori per entrambe le metriche.
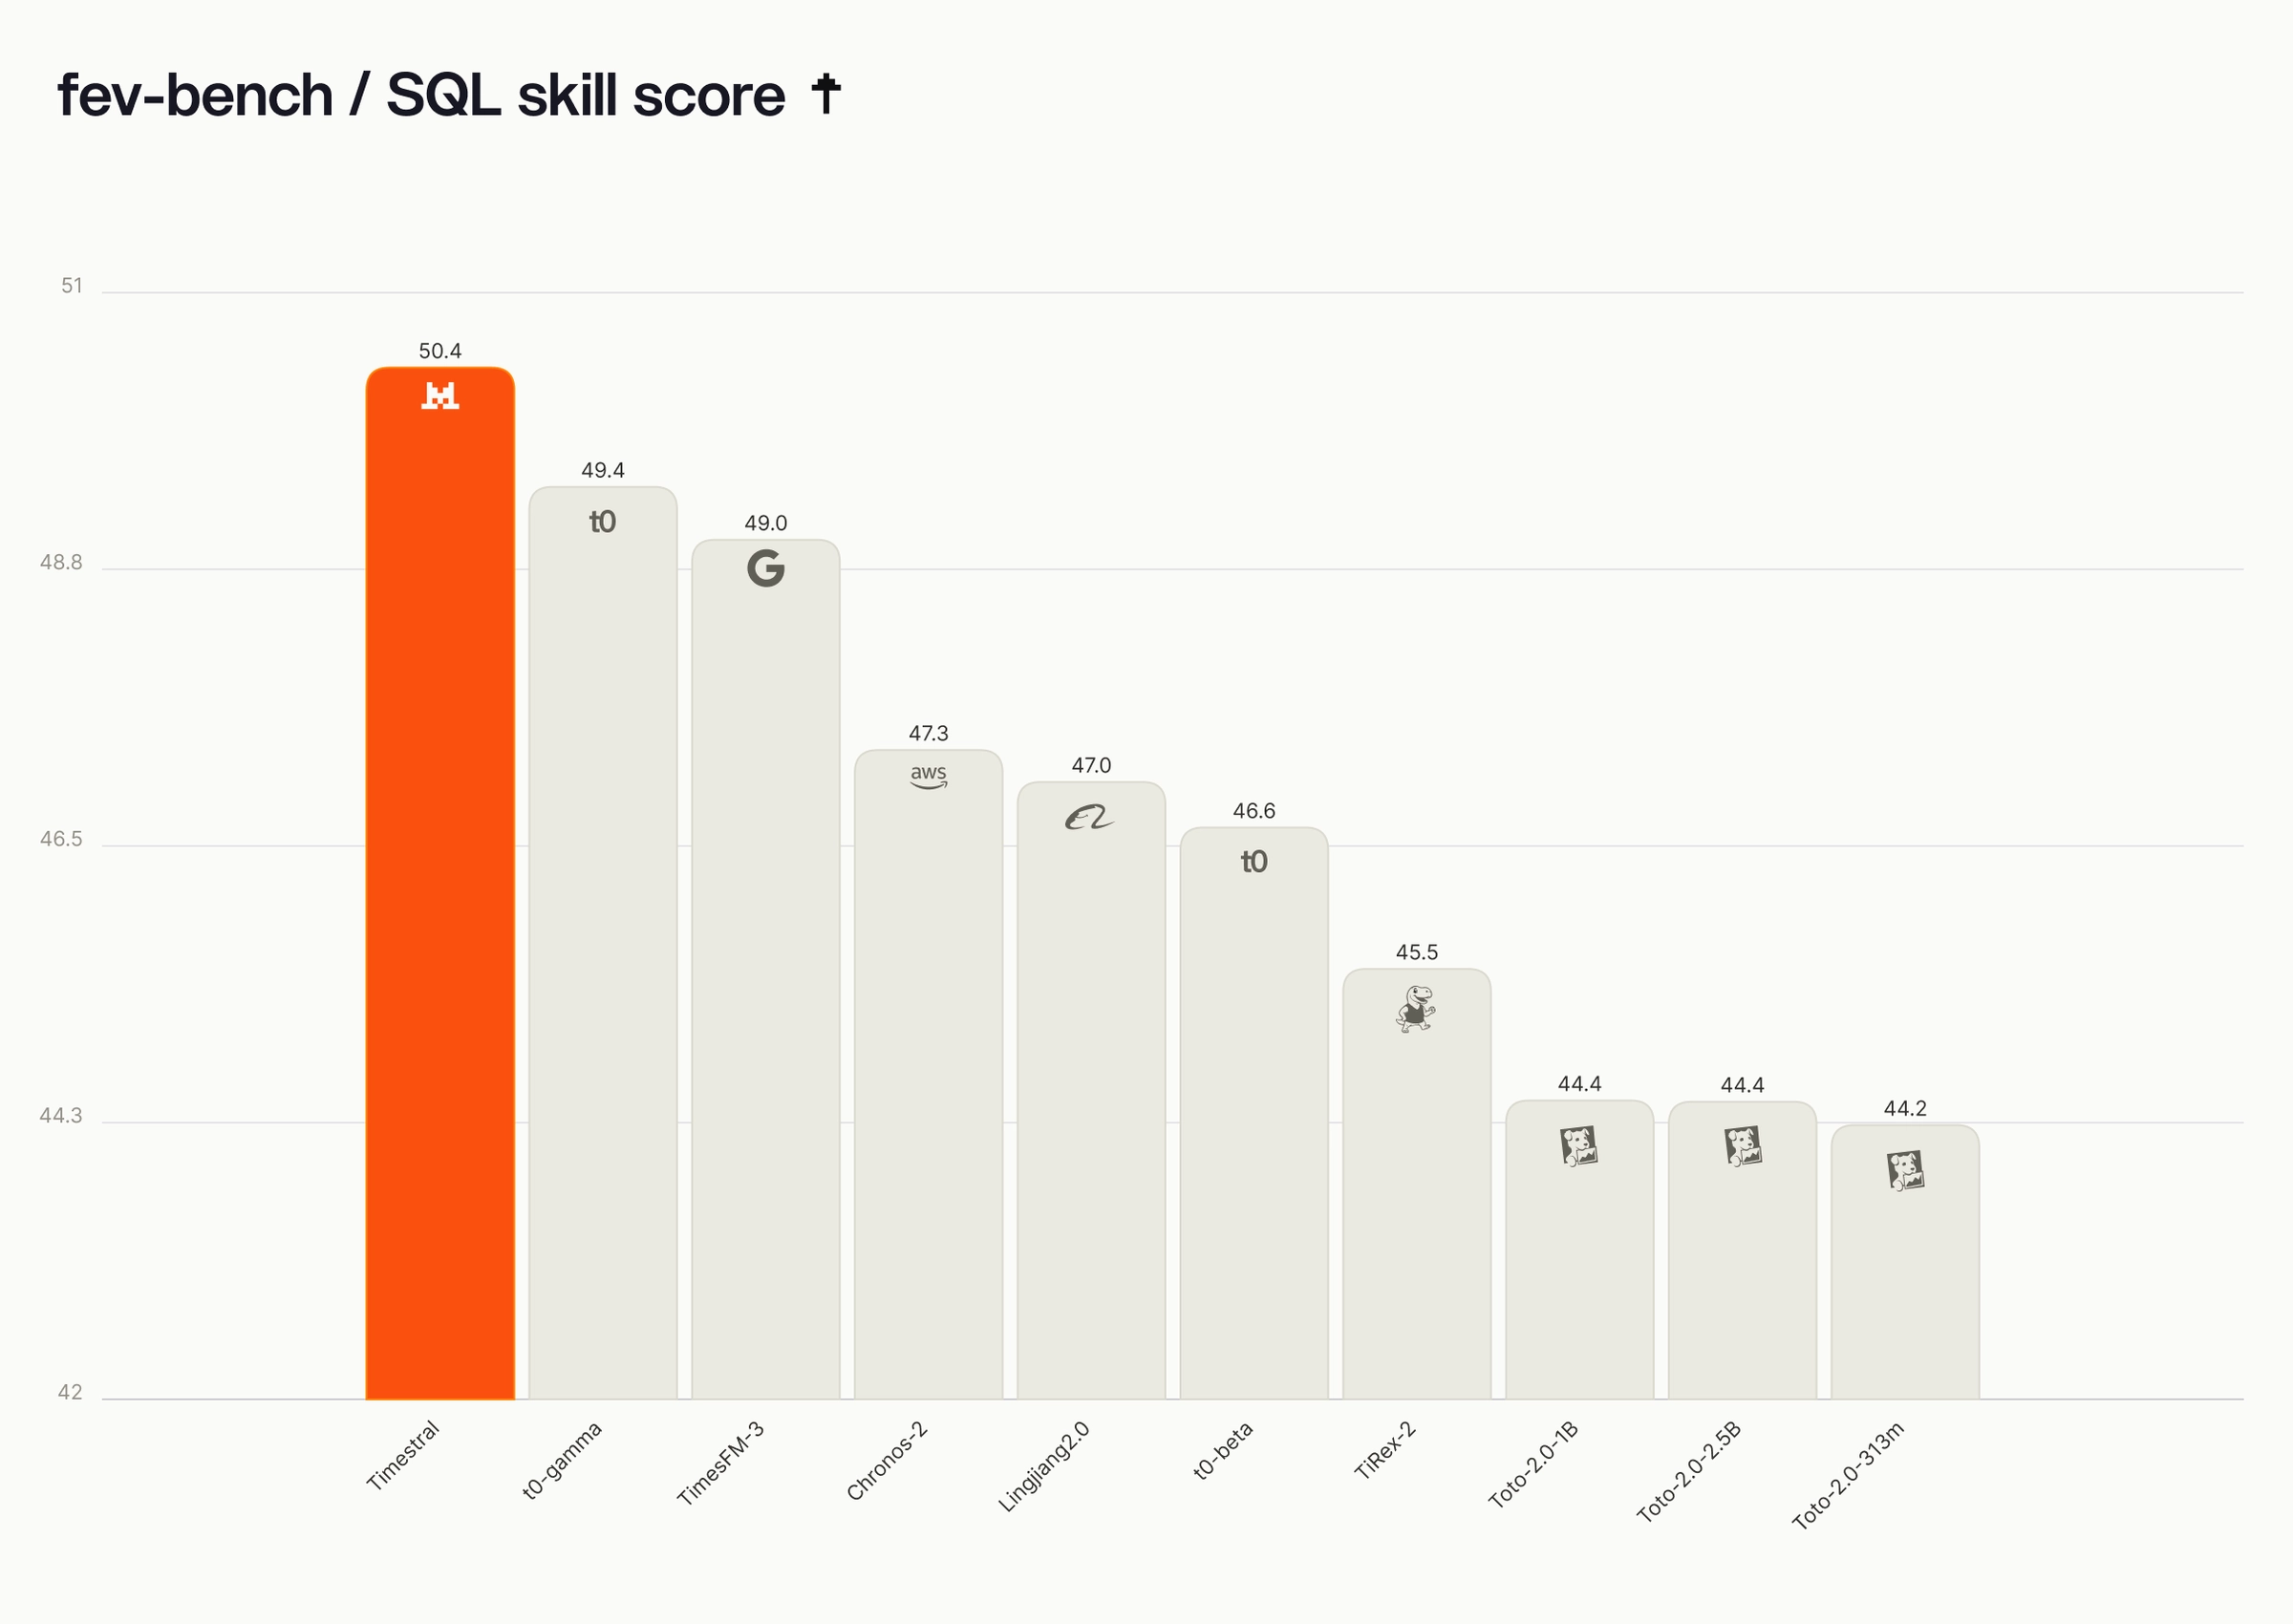
fev-bench, prime dieci posizioni delle 37 voci in classifica, in base al punteggio skill SQL. Valori più alti sono migliori.
Una famiglia di modelli ottimizzata per ogni esigenza
Timestral è stato ottimizzato come famiglia di quattro modelli: 5M, 28M, 123M e 209M parametri. I modelli più grandi migliorano le prestazioni di previsione, mentre quelli più piccoli sono più rapidi ed economici. Tutti e quattro condividono la stessa architettura e la stessa ricetta di addestramento. Ogni taglia si colloca sul fronte di Pareto tra accuratezza e dimensioni del modello: per ciascuna taglia, nessun modello pubblico offre previsioni migliori.
Punteggio rispetto alle dimensioni del modello su GIFT-Eval, TIME e fev-bench (mostrato come 1 − punteggio skill). Valori più bassi sono migliori. Il nostro modello da 28M supera Chronos-2, circa quattro volte più grande, su GIFT-Eval e TIME. Il nostro modello da 209M supera TimesFM-3 e Falcon-2.0 con meno parametri.
Timestral non richiede una GPU in fase di inferenza. Su una CPU server standard con 8 thread, la previsione a un giorno a partire da tre settimane di storico a intervalli di 15 minuti richiede 10 ms con il modello da 5M e 140 ms con il modello da 209M. I modelli più piccoli sacrificano parte dell'accuratezza in cambio della velocità: il modello da 28M è cinque volte più veloce del modello da 209M, mentre il modello da 123M arriva a meno dello 0,2% dal punteggio del 209M con una latenza pari ai tre quarti.
Un esempio industriale
Si consideri un impianto industriale con migliaia di sensori distribuiti sulle apparecchiature. Timestral può migliorare le previsioni su questi dati in diversi modi.
Previsione multivariata. La vibrazione, la temperatura e la pressione di una pompa non variano in modo indipendente. L'aumento di una spesso spiega o causa una variazione in un'altra. Timestral modella congiuntamente le serie correlate, così da poter sfruttare tali dipendenze invece di prevedere ciascun sensore in modo isolato.
Previsione probabilistica. Un singolo valore previsto può non mostrare il quadro completo. Timestral prevede un insieme completo di quantili, così i team possono vedere quanto è ampia l'incertezza, impostare soglie di avviso che la riflettano e pianificare la manutenzione in base al rischio anziché a un singolo numero.
Covariate categoriali. Alcune covariate assumono valori da un insieme di categorie anziché da numeri continui, come il giorno della settimana o lo stato di una macchina (in funzione, inattiva, in manutenzione). Codificarle come numeri imporrebbe un ordine o una scala che non hanno. Timestral le accetta direttamente come input categoriali per migliorare le previsioni.
Covariate a futuro noto. Alcuni fattori che determinano il comportamento dei sensori sono noti in anticipo, come i programmi di produzione, gli arresti pianificati e le previsioni meteorologiche. Timestral può condizionarsi su di essi per migliorare la qualità delle previsioni, così un aumento pianificato del carico viene atteso anziché segnalato come imprevisto.
Dal modello al sistema
Timestral è un modello numerico che può essere eseguito all'interno delle pipeline di monitoraggio esistenti o essere affiancato ai nostri modelli linguistici in flussi di lavoro agentici multimodali.
Nell'impianto, la situazione potrebbe presentarsi così:
Timestral in esecuzione continua sui flussi di dati dei sensori dell'impianto, rilevando le anomalie appena si verificano.
Quando segnala un'anomalia su una pompa, un agente genera gli embedding dei segnali e li confronta con gli embedding dei dati storici dei sensori per individuare guasti simili verificatisi in passato.
L'agente avvia quindi sub-agenti per condurre un'analisi delle cause radice, attingendo al contesto di quell'impianto, come i registri di manutenzione, i registri di turno e le note degli operatori, i manuali delle apparecchiature, gli ordini di lavoro passati e le letture delle apparecchiature correlate.
L'agente redige una diagnosi proposta basata sui risultati, con evidenze a supporto e possibili passaggi successivi.
Il responsabile dell'impianto riceve una diagnosi e un piano supportati dai dati dei sensori, anziché un semplice avviso.
Principali contributi tecnici
Diverse idee sono state combinate per ottenere questi risultati. Ciascuna verrà descritta in dettaglio nel rapporto tecnico.
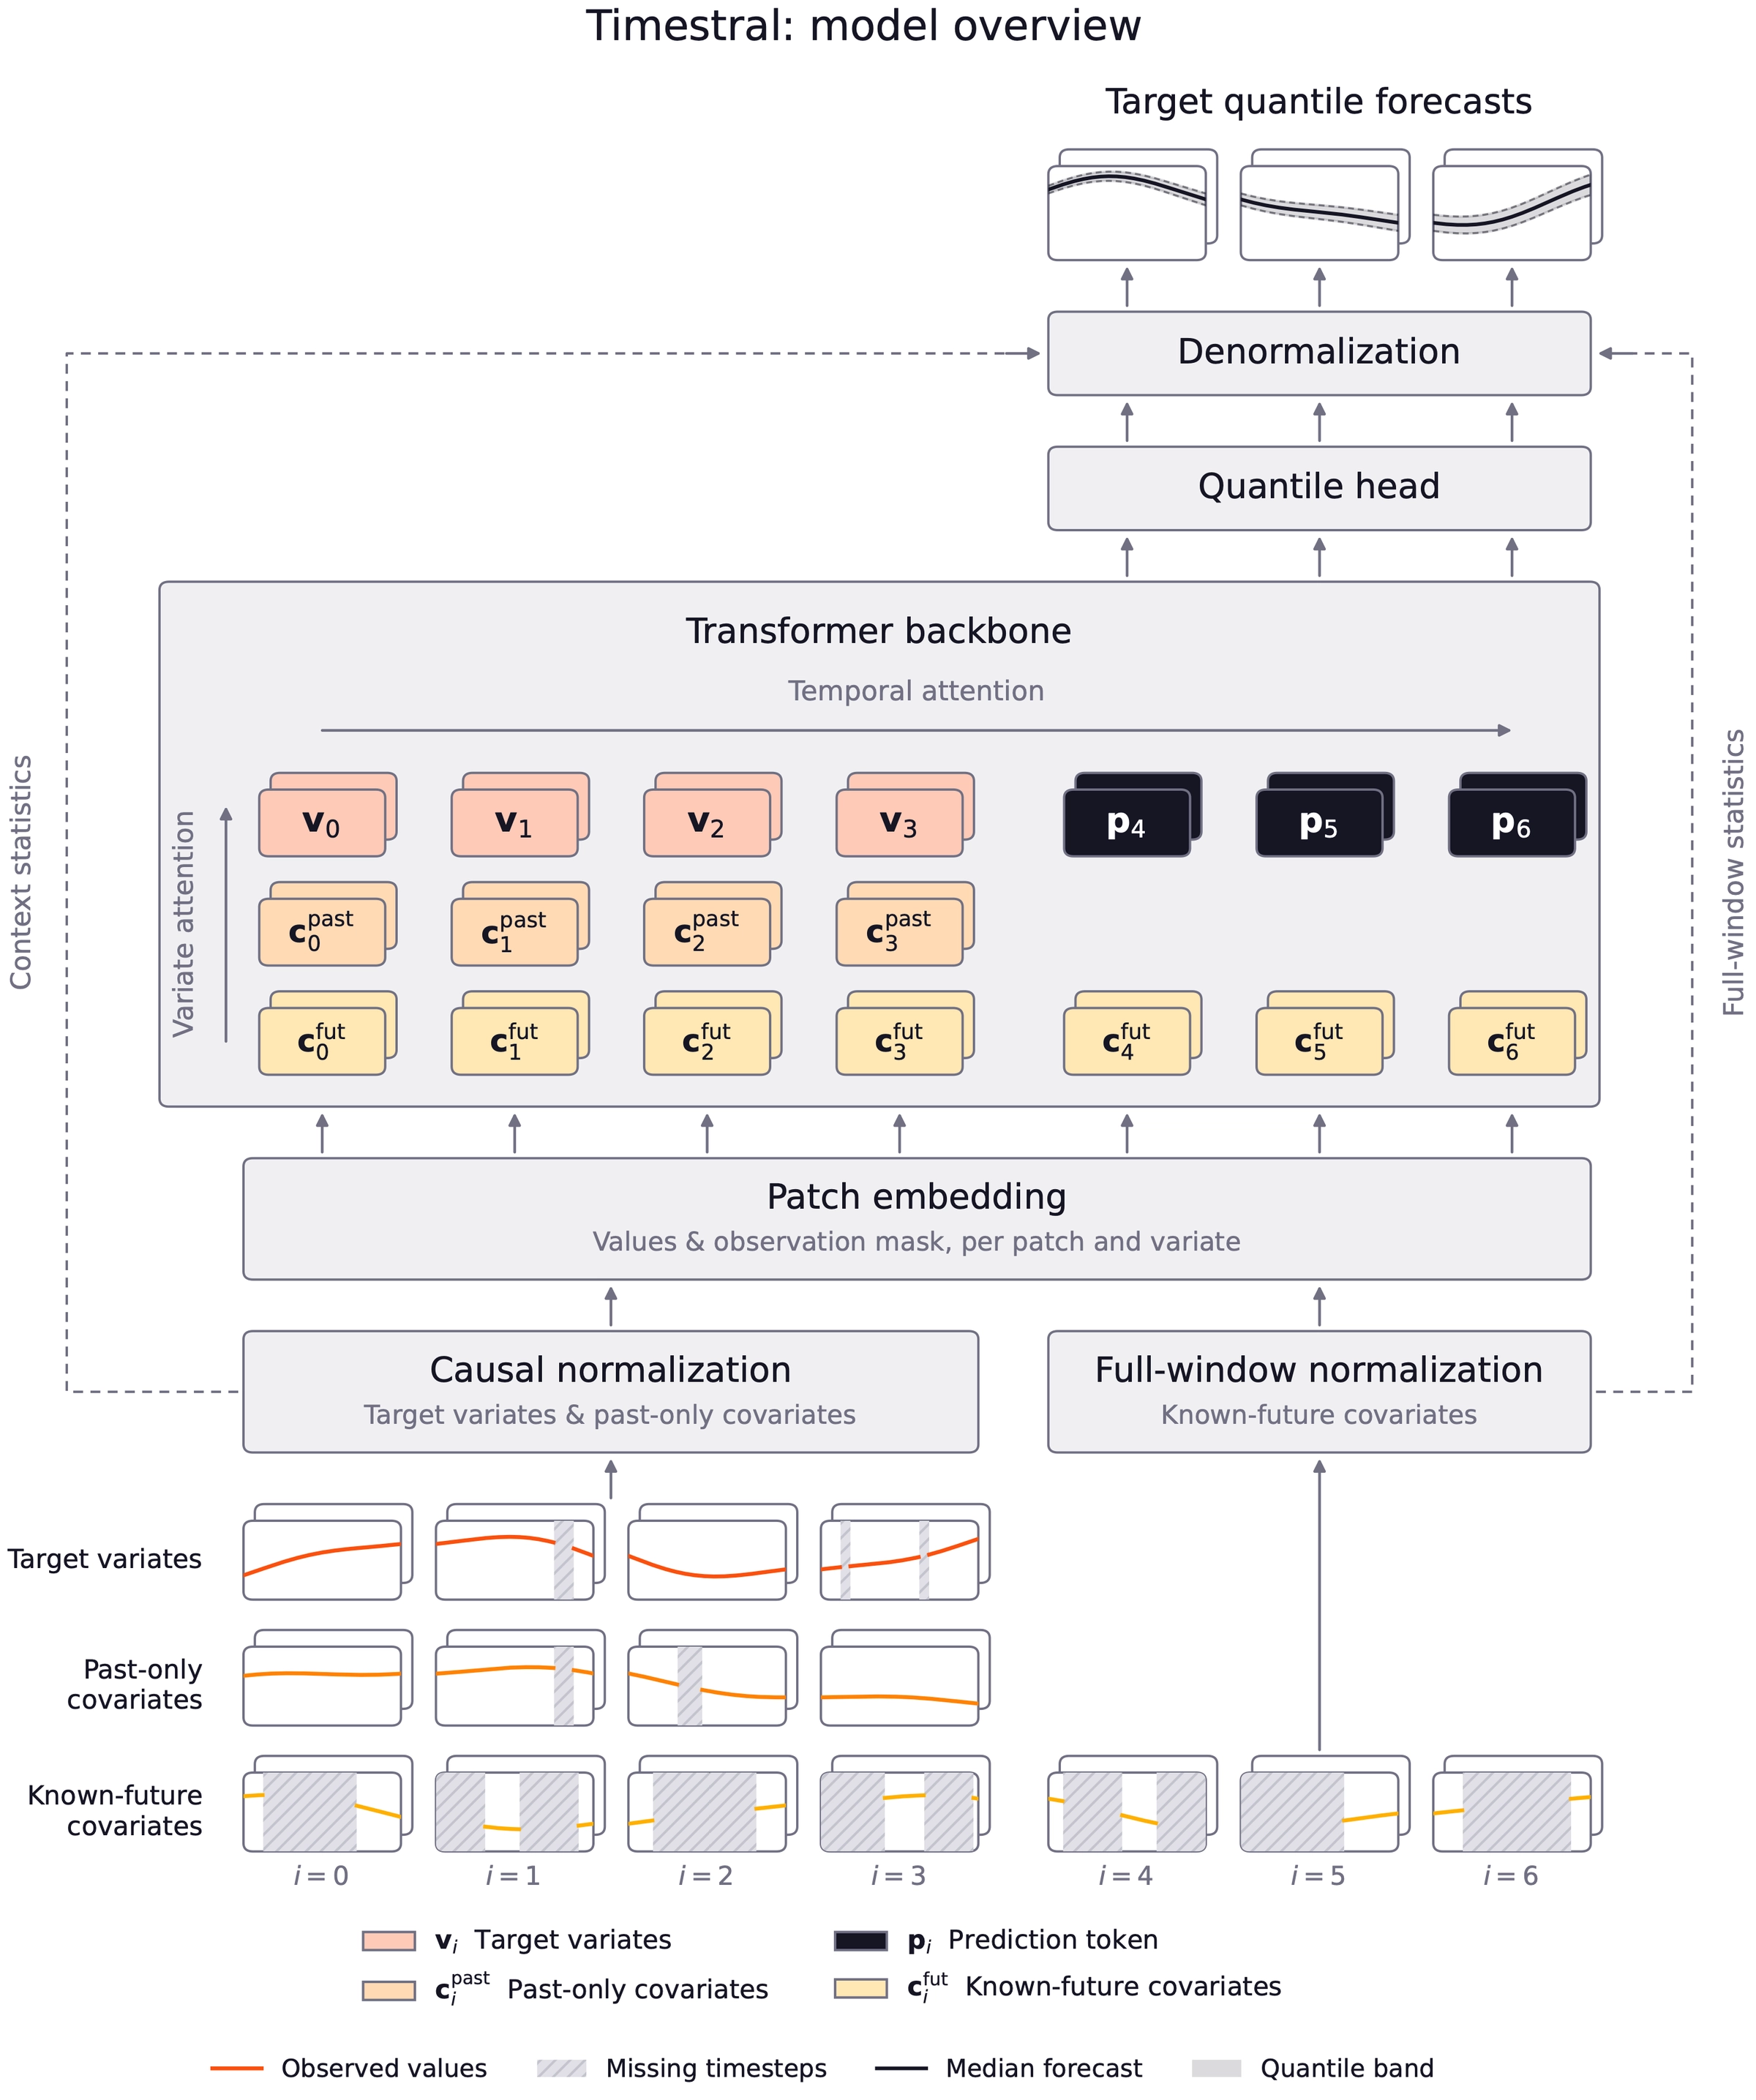
Previsione con orizzonte disaccoppiato. I decoder causali addestrati con mascheramento contiguo delle patch, come in Toto 2.0 e TimesFM-3, mascherano i valori da prevedere, che appaiono quindi come valori mancanti e vanno perduti anche come contesto per le previsioni successive. Il nostro approccio, DHF, separa le due cose: la storia completa resta nella sequenza e i token di previsione appresi leggono la storia che li precede. Ogni valore osservato funge così sia da target sia da contesto, i vuoti reali restano contrassegnati come mancanti e le lunghezze degli orizzonti di addestramento e la data augmentation con dati mancanti possono essere regolate indipendentemente l'una dall'altra.
Attenzione consapevole delle covariate. A ogni serie di input viene assegnato un ruolo: variabile target, covariata solo-passata o covariata a futuro noto. Le covariate a futuro noto sono visibili sull'intera finestra mentre i target restano causali e le informazioni fluiscono solo dalle covariate ai target. Timestral può quindi utilizzare un calendario di festività o una previsione meteorologica senza far trapelare il futuro del target stesso nella relativa previsione.
Dati sintetici prima di tutto. La maggior parte dei dati di addestramento era sintetica. Abbiamo dapprima generato processi univariati con dinamiche temporali coerenti, comprendenti trend, stagionalità e pattern di rumore diversificati. Abbiamo quindi utilizzato un sintetizzatore multivariato per costruire serie multivariate introducendo dipendenze non lineari tra questi processi.
Addestramento in due fasi. Timestral viene innanzitutto pre addestrato su larga scala su dati puramente sintetici con dimensione del contesto pari a 8192, quindi post addestrato su una miscela di dati reali e sintetici con un contesto 4 volte più lungo. L'obiettivo è una pinball loss su 21 quantili, un'approssimazione discreta del CRPS.
Un modello adattabile
I benchmark pubblici misurano le prestazioni generali, ma i dati di produzione possono differire in modo significativo per comportamento e struttura. Possono inoltre evolversi nel tempo, man mano che i mercati cambiano regime, le apparecchiature si degradano e i pattern della domanda si spostano. Il valore duraturo sta nella possibilità di adattare un modello ai dati del proprio dominio e di riaddestrarlo costantemente al variare della distribuzione.
Per le organizzazioni che desiderano andare oltre, Timestral è disponibile tramite Mistral Forge, la stessa pipeline di addestramento che utilizziamo per i nostri modelli linguistici. Supporta:
Inferenza zero-shot pronta all'uso.
Estensioni architettoniche, come covariate specifiche del dominio.
Fine-tuning su dati proprietari, per specializzarsi su un dominio preservando le prestazioni generali.
Controllo sui dati di addestramento, inclusa la modifica della miscela di addestramento, il replay dei dati di pre addestramento e la generazione di campioni di dati sintetici per riflettere il dominio di destinazione. Il controllo completo sui dati garantisce che nulla di ciò che sottoponiamo a backtest sia stato visto durante il pre addestramento.
L'intera pipeline può essere implementata sull'hardware dei nostri clienti, inclusi gli ambienti air-gapped.
Prossimi passi
Abbiamo pubblicato un repository GitHub per consentirLe di eseguire Timestral sui Suoi dati. Un rapporto tecnico con i risultati completi seguirà. Per problemi di previsione più specialistici o per collaborare alla ricerca, La invitiamo a contattarci.
Timestral | |
|---|---|
Tipo | Modello di fondazione per serie temporali (TSFM) |
Parametri | 5M, 28M, 123M e 209M |
Lunghezza del contesto | 32.768 step temporali |
Output | Previsioni probabilistiche, 21 quantili |
Input | Target multivariati, covariate solo-passate e a futuro noto |
Distribuzione | On-premise, VPC o air-gapped |
Licenza | MIT modificata |