Thinking
Summary
Timestral, la première famille de modèles de fondation pour séries temporelles de Mistral, offre des prévisions probabilistes multivariées à l'état de l'art avec seulement 209 M de paramètres, surpassant des modèles plus grands sur les benchmarks clés tout en prenant en charge les covariables passées et futures. Disponible en quatre tailles (de 5 M à 209 M de paramètres), Timestral équilibre précision et efficacité, s'exécute efficacement sur CPU et excelle en prévision zero-shot dans des domaines variés. Le modèle combine un préentraînement synthétique, une attention prenant en compte les covariables et un apprentissage à long contexte, avec des options de fine-tuning pour l'adaptation à un domaine via Mistral Forge.
Aujourd'hui, nous publions Timestral, notre première famille de modèles de fondation pour séries temporelles. Notre plus grand modèle, à seulement 209M de paramètres, occupe la première place sur les trois principaux benchmarks publics du domaine — GIFT-Eval, TIME et fev-bench — et dépasse l'état de l'art précédent avec seulement deux tiers de ses paramètres.
Timestral produit des prévisions probabilistes et multivariées, et prend en charge les covariables passées uniquement et les covariables à futur connu. Notre famille de modèles se situe sur le front de Pareto entre la précision des prévisions et la taille du modèle, avec des performances de pointe à chaque taille. Les résultats ont été soumis aux leaderboards GIFT-Eval et TIME.
Modèles de fondation pour séries temporelles (TSFM)
Les séries temporelles comptent parmi les types de données les plus courants en entreprise, de la télémétrie des capteurs aux métriques d'observabilité. Les prévisions qui s'y appuient orientent les décisions en matière de planification de capacité, d'énergie, de chaînes d'approvisionnement, de gestion des risques et de maintenance.
Les usines prévoient les signaux des capteurs de process par rapport au programme de production, détectent la dérive des équipements avant qu'ils ne tombent en panne, et planifient la capacité et les pièces de rechange sur des milliers d'actifs. Les équipes financières prévoient les flux, les volumes et la volatilité pour éclairer leurs positions, leurs couvertures et leur trésorerie sur des milliers de comptes.
Les modèles classiques comme ARIMA et la régression linéaire restent des outils éprouvés pour la prévision de séries temporelles. Ces modèles sont en général ajustés à une seule série et n'apprennent qu'à partir de l'historique de cette série.
Les modèles de deep learning comme PatchTST apportent la capacité d'apprendre des motifs non linéaires sur de nombreuses séries liées, mais ils restent généralement entraînés de zéro sur chaque ensemble de données, si bien que ce qu'ils apprennent ne se transpose pas à de nouveaux domaines.
Les modèles de fondation pour séries temporelles appliquent l'approche du préentraînement à ce type de données. Entraîné sur un corpus vaste et diversifié, notre modèle apprend des motifs transférables d'une série à l'autre et produit des prévisions zero-shot sur des données qu'il n'a jamais vues, même dans des domaines où les données sont rares.
Résultats des benchmarks
Nous avons évalué Timestral sur les trois principaux benchmarks publics de prévision : GIFT-Eval, TIME et fev-bench. Parmi les modèles préentraînés et zero-shot, il occupe la première place sur les cinq métriques. Ces résultats proviennent d'un seul checkpoint, sans ensembling.
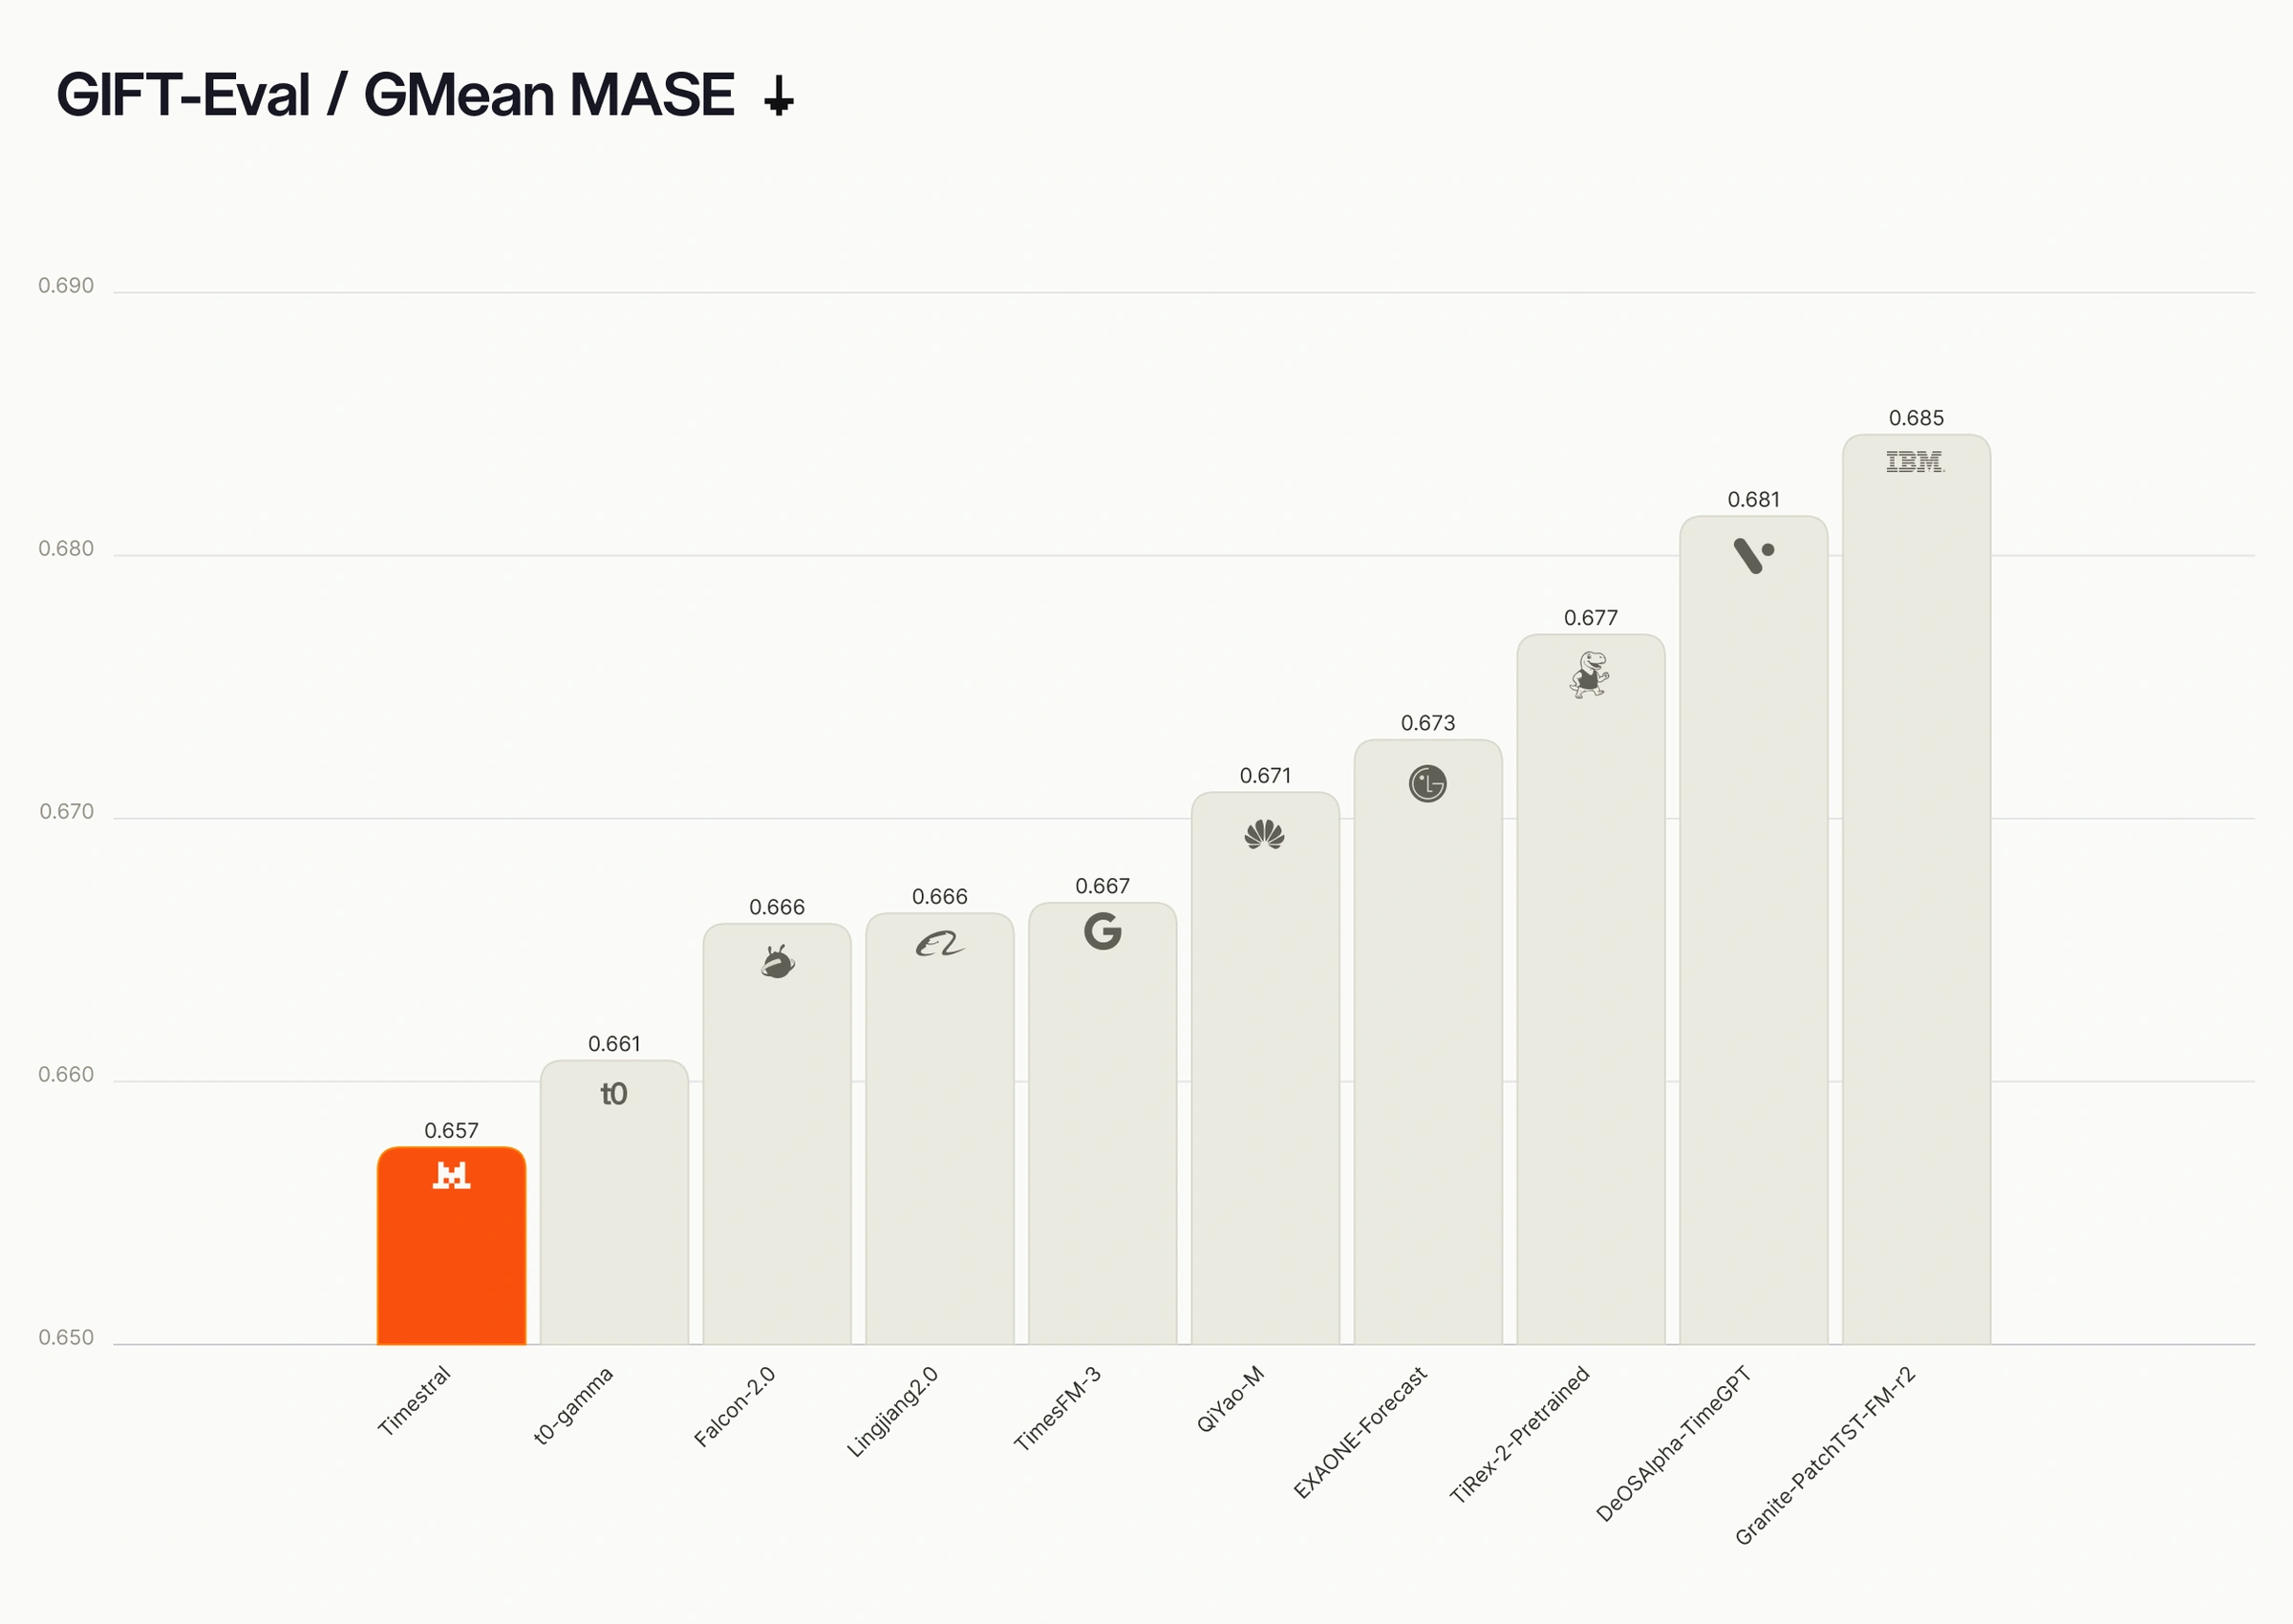
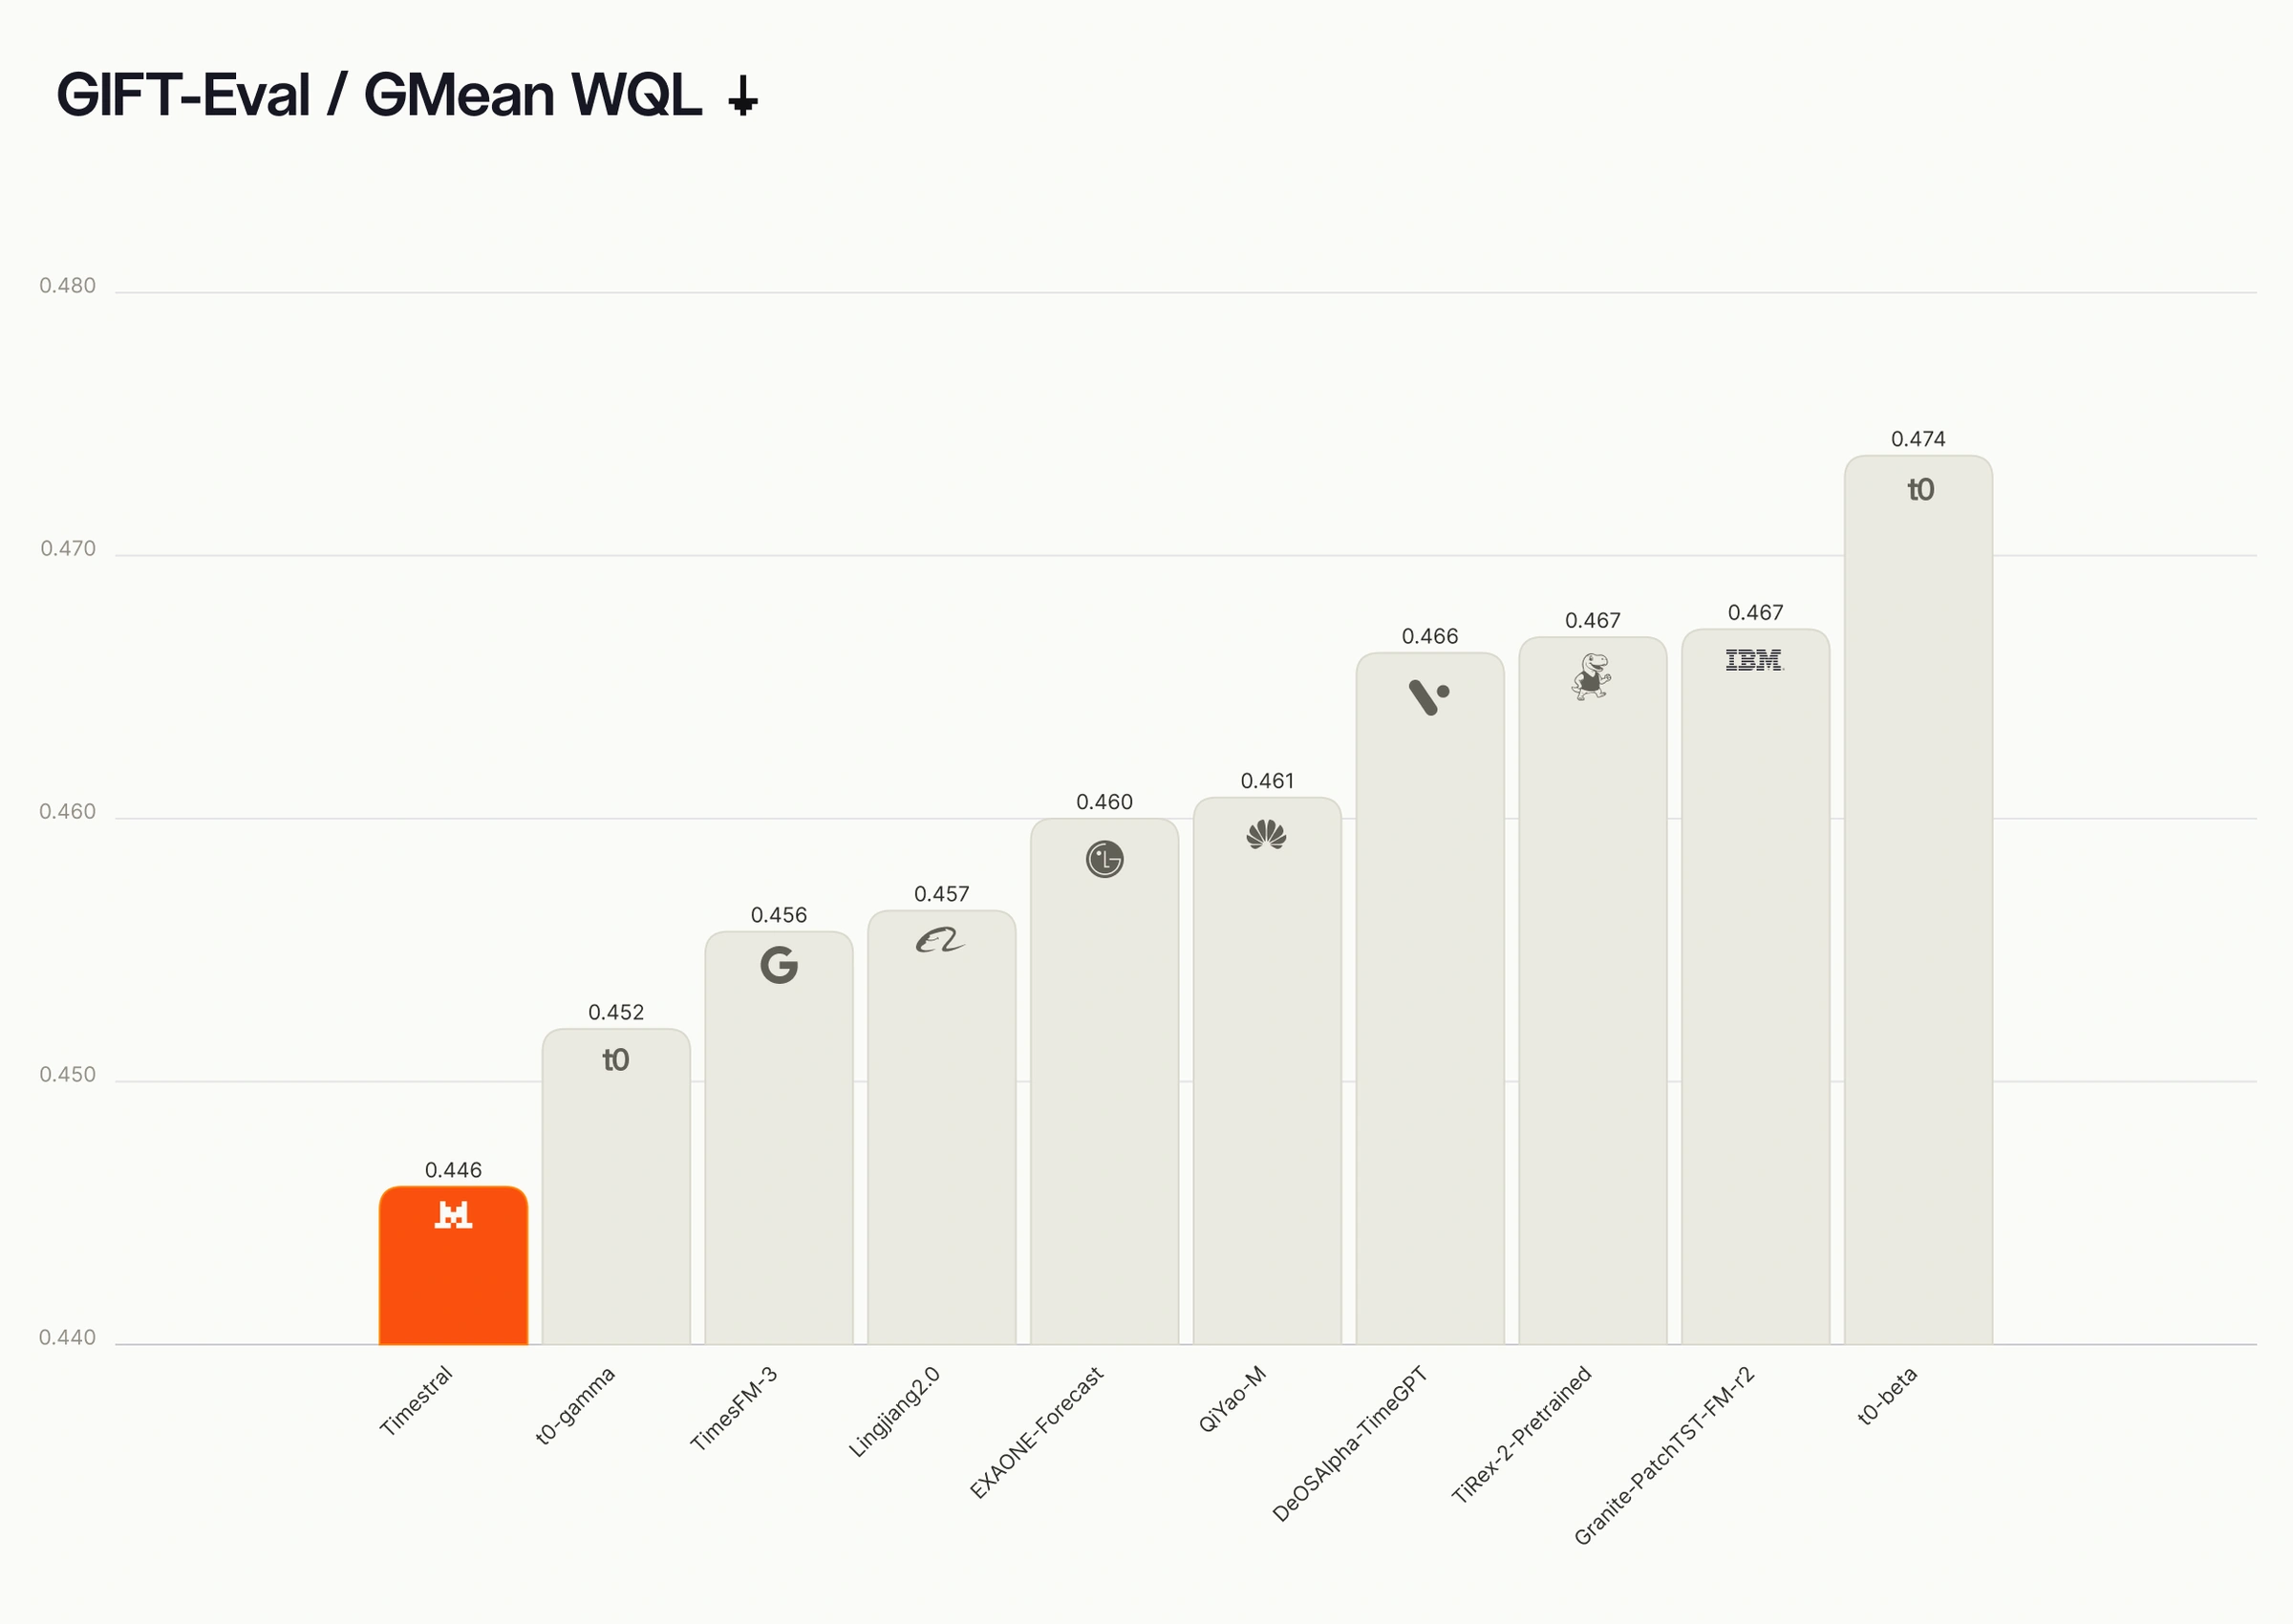
GIFT-Eval, les dix premières des 83 entrées comparables, préentraînées et zero-shot. Plus la valeur est basse, mieux c'est.
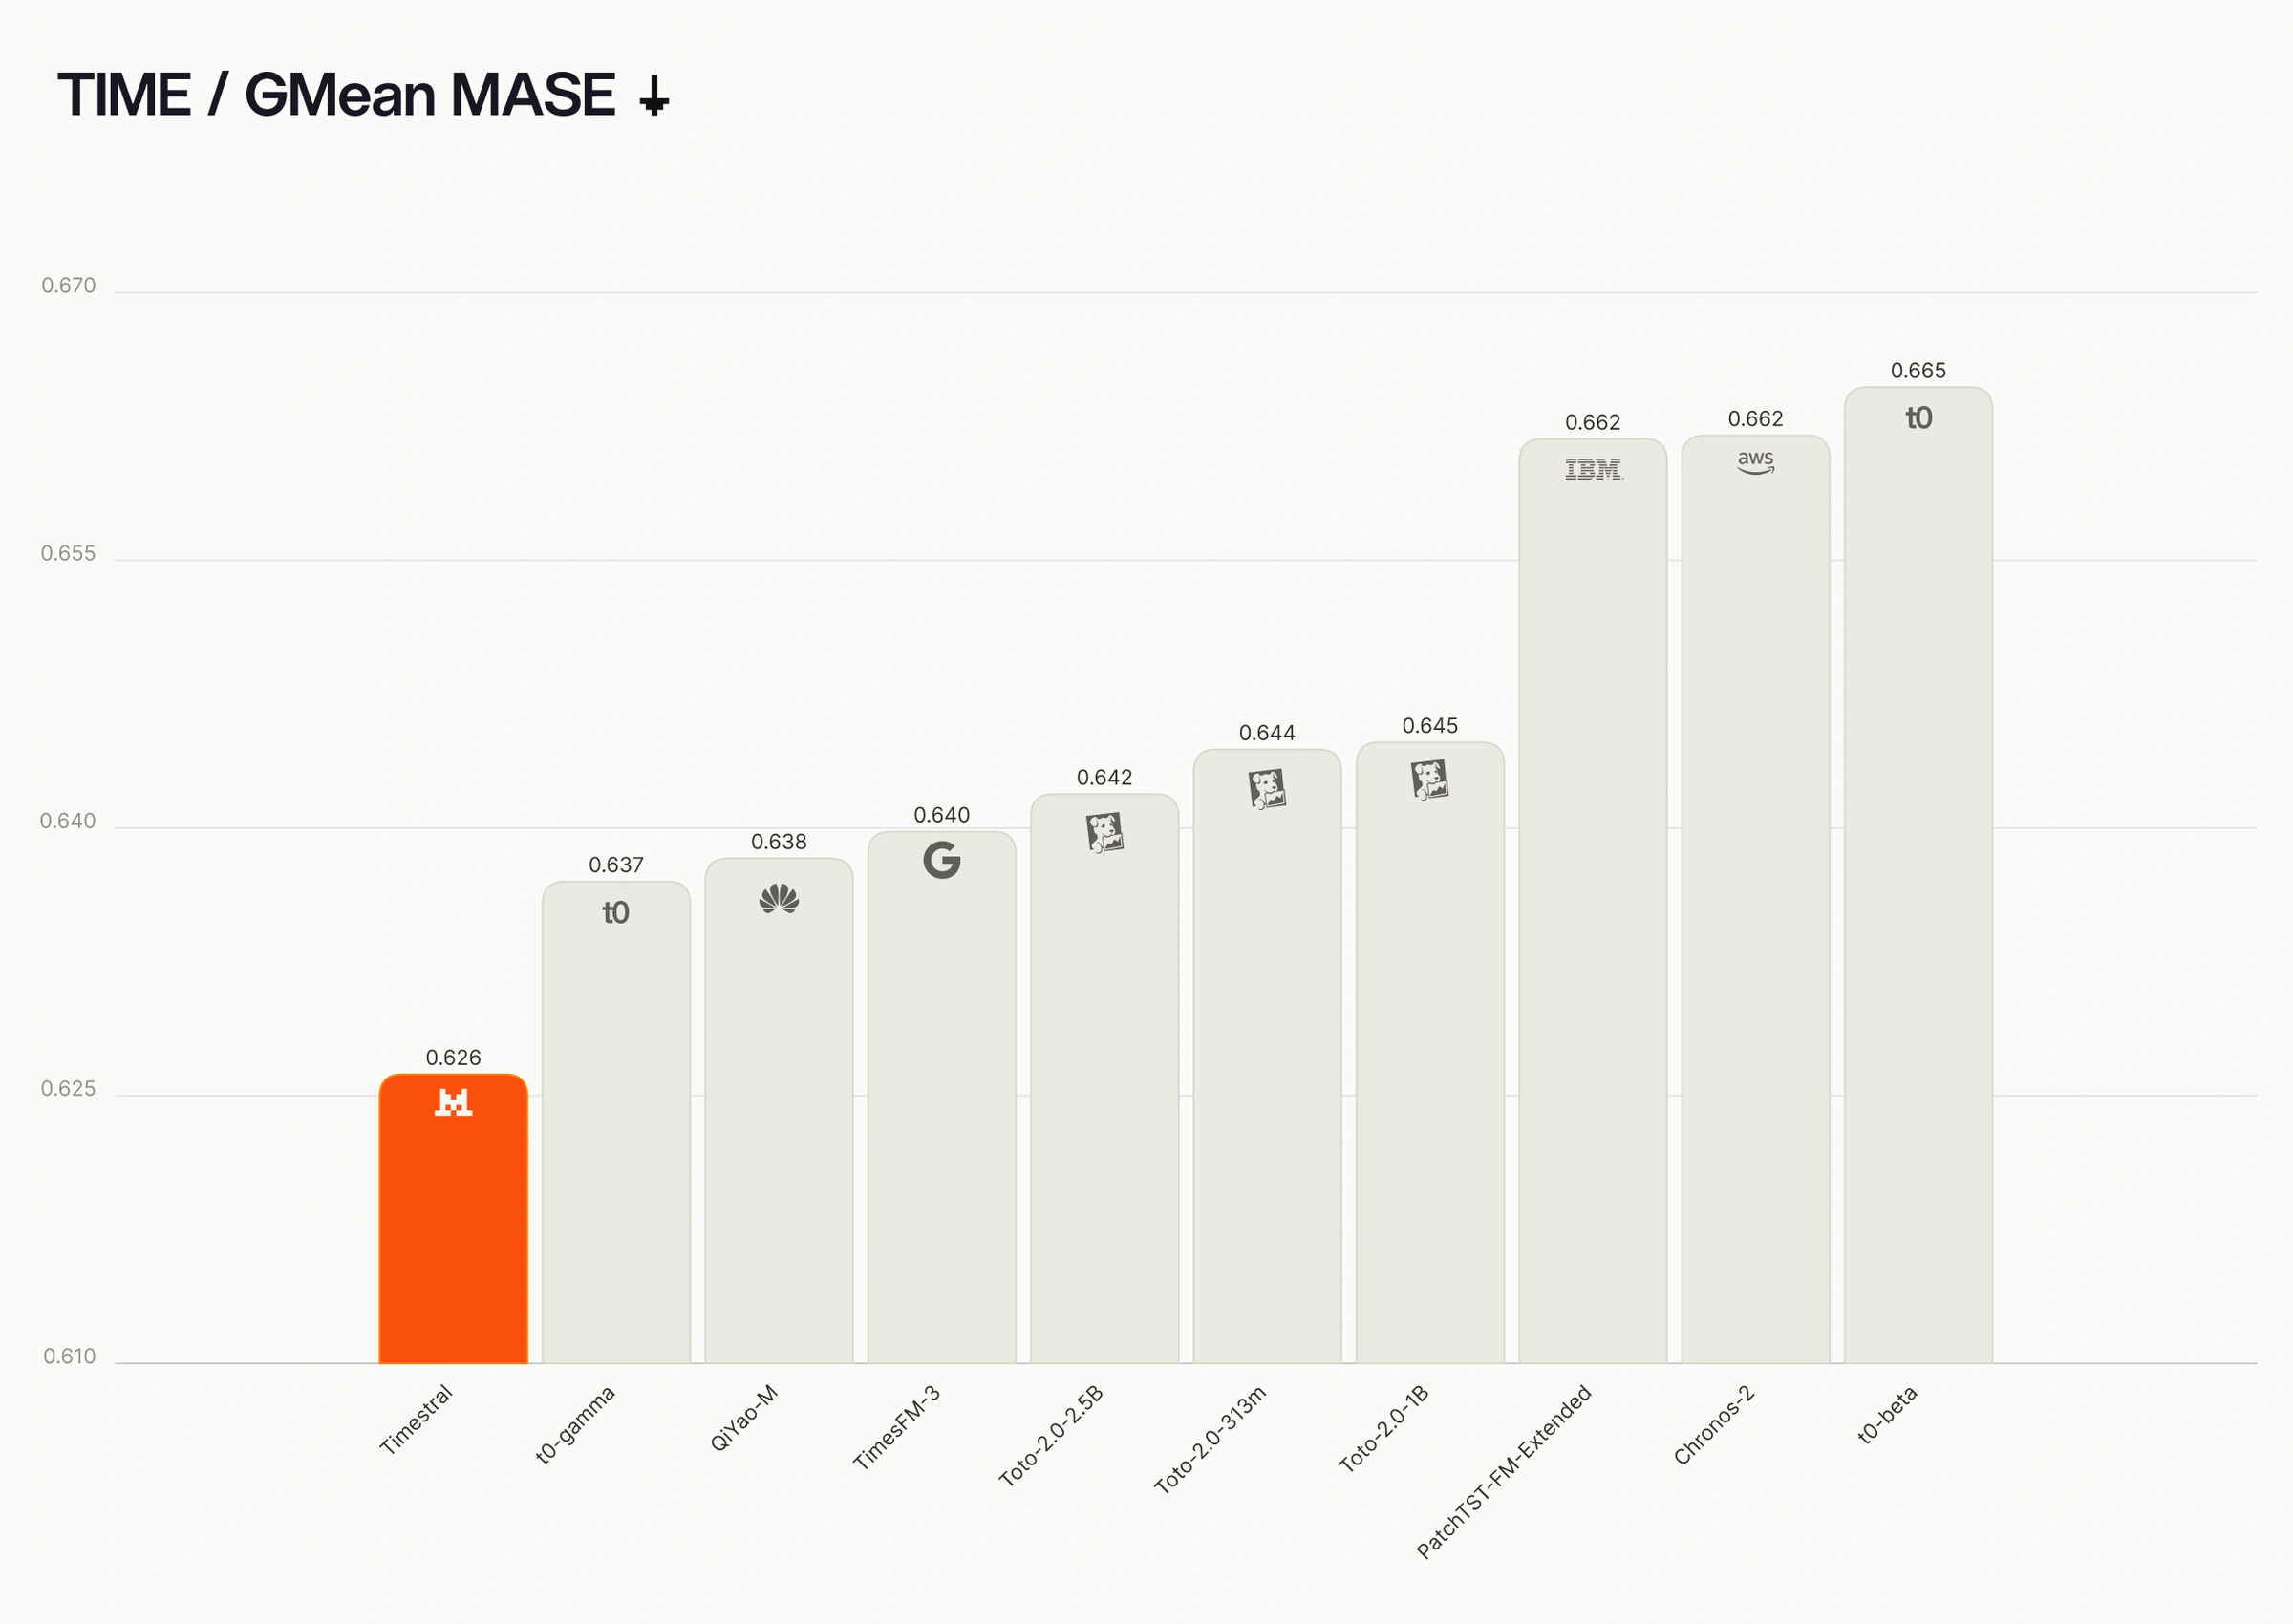
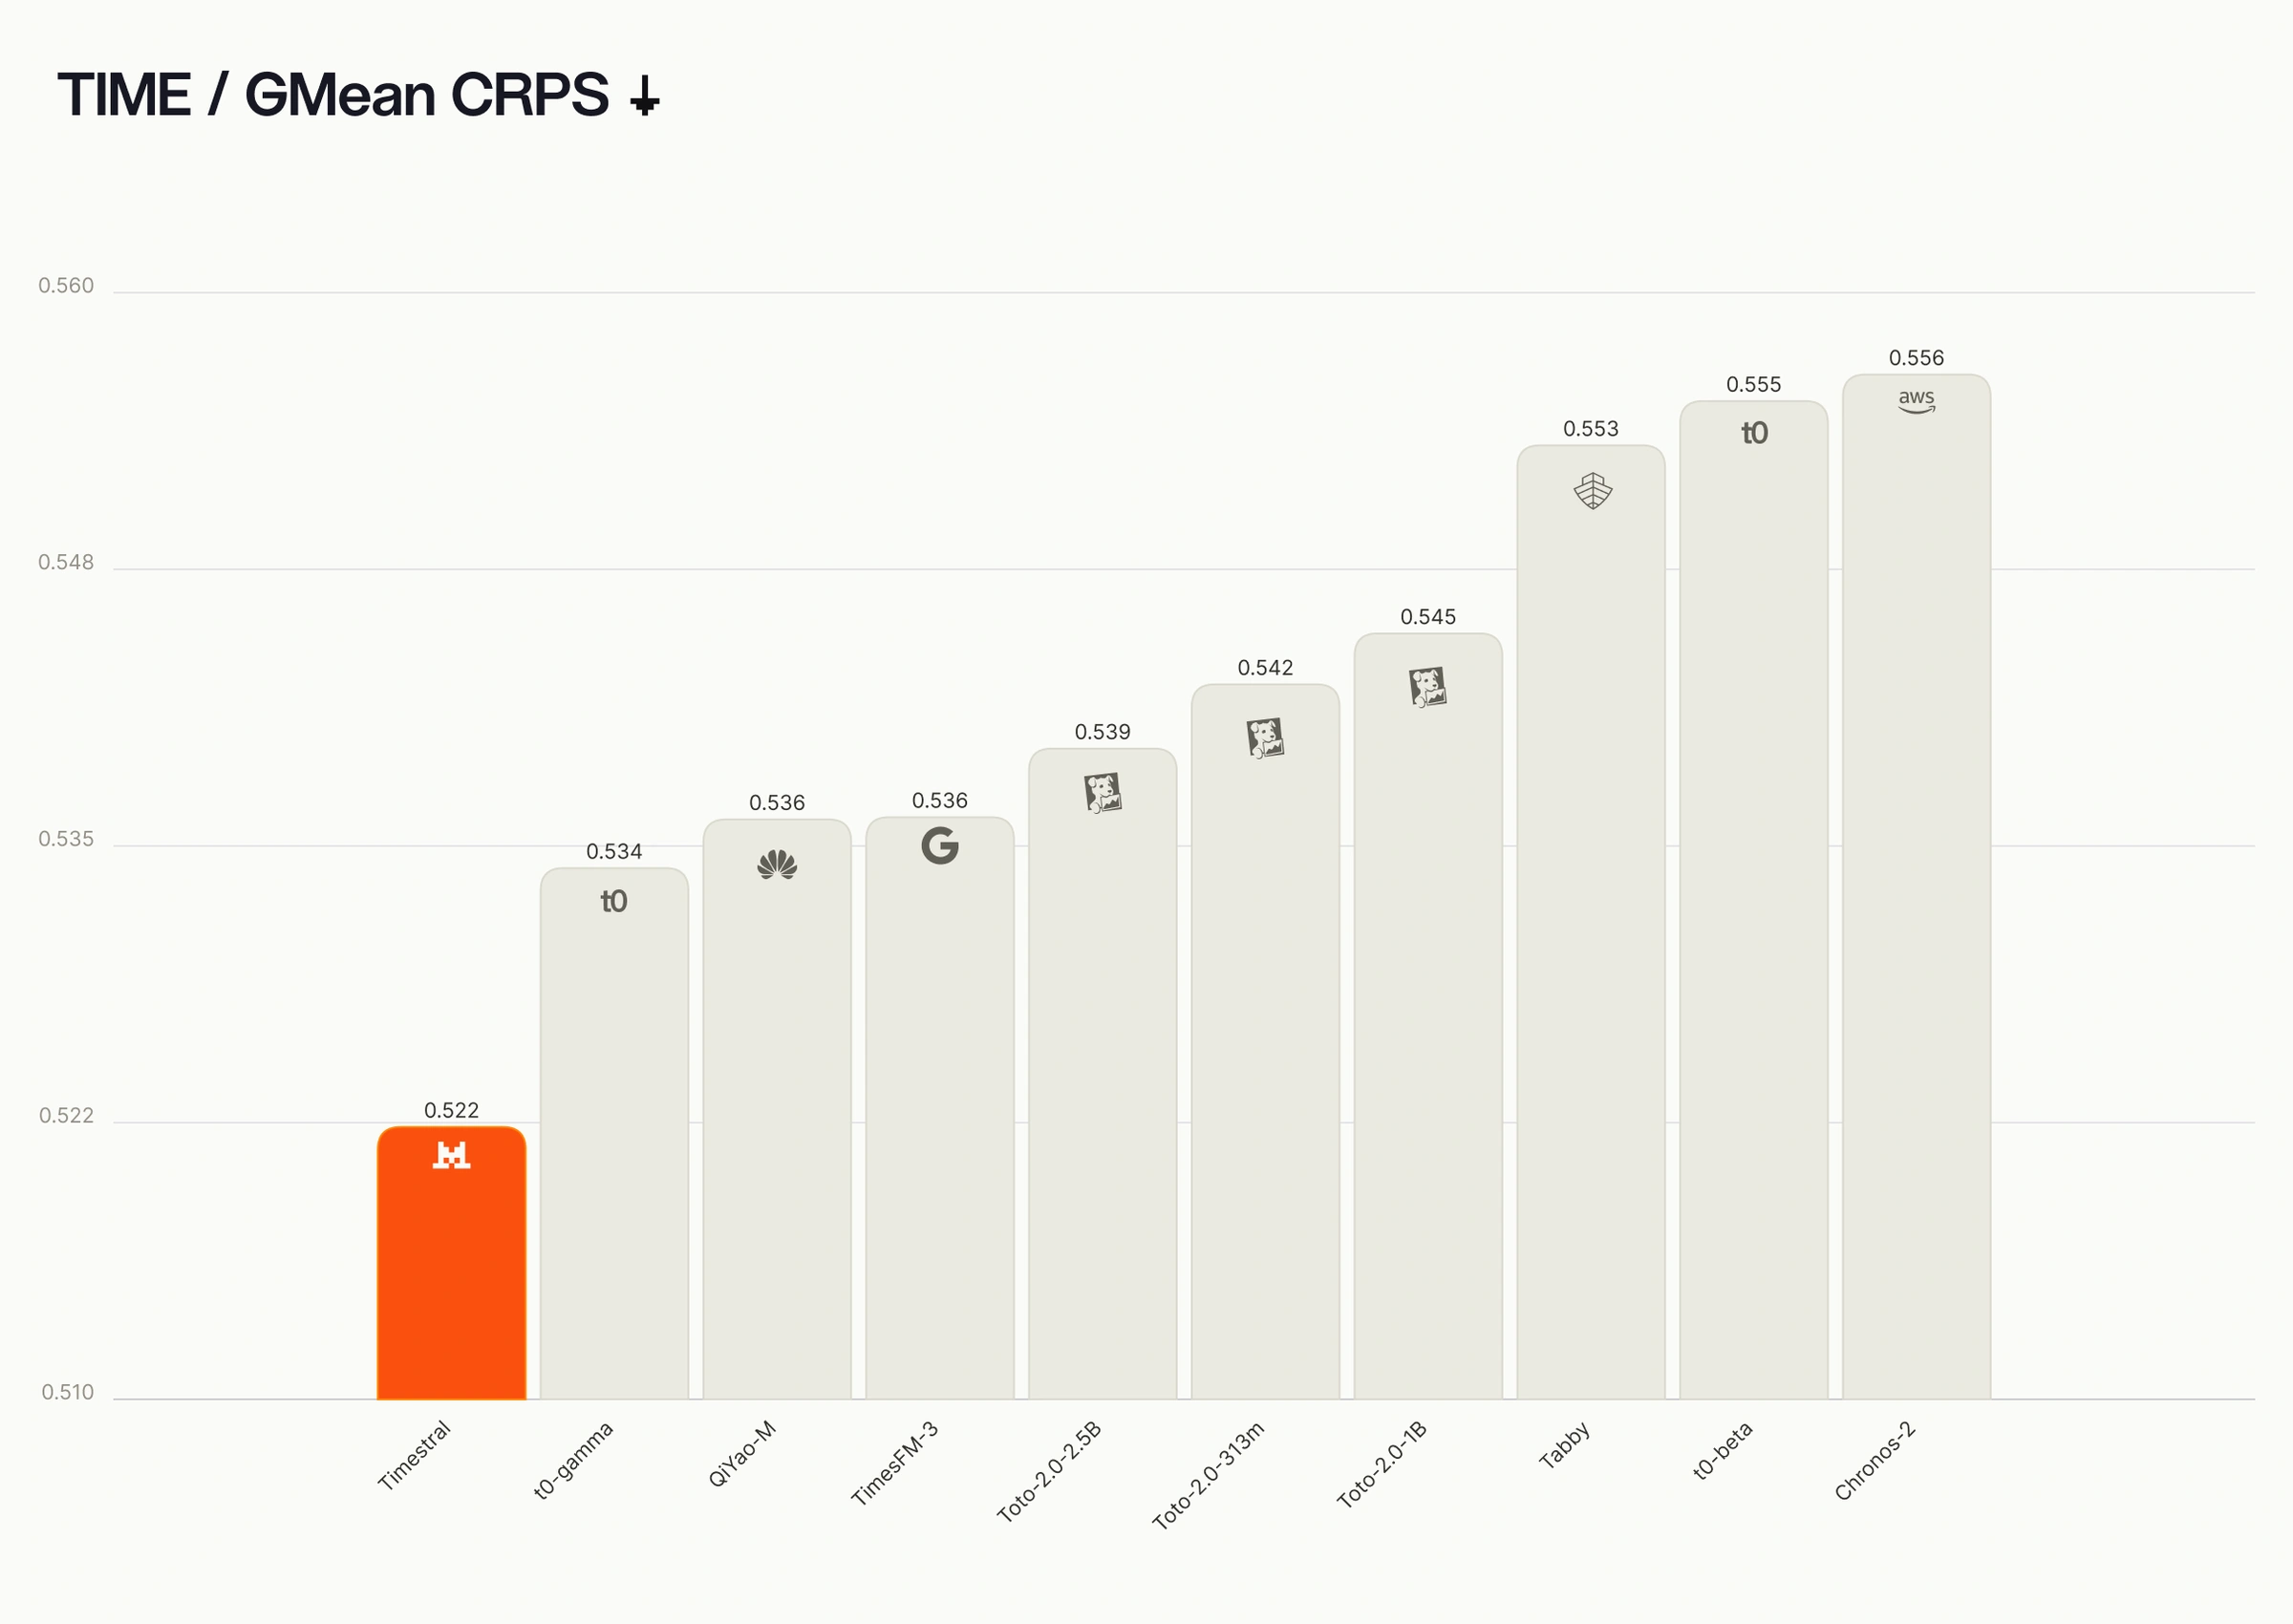
TIME, les dix premières des 35 entrées du leaderboard. Plus la valeur est basse, mieux c'est sur les deux métriques.
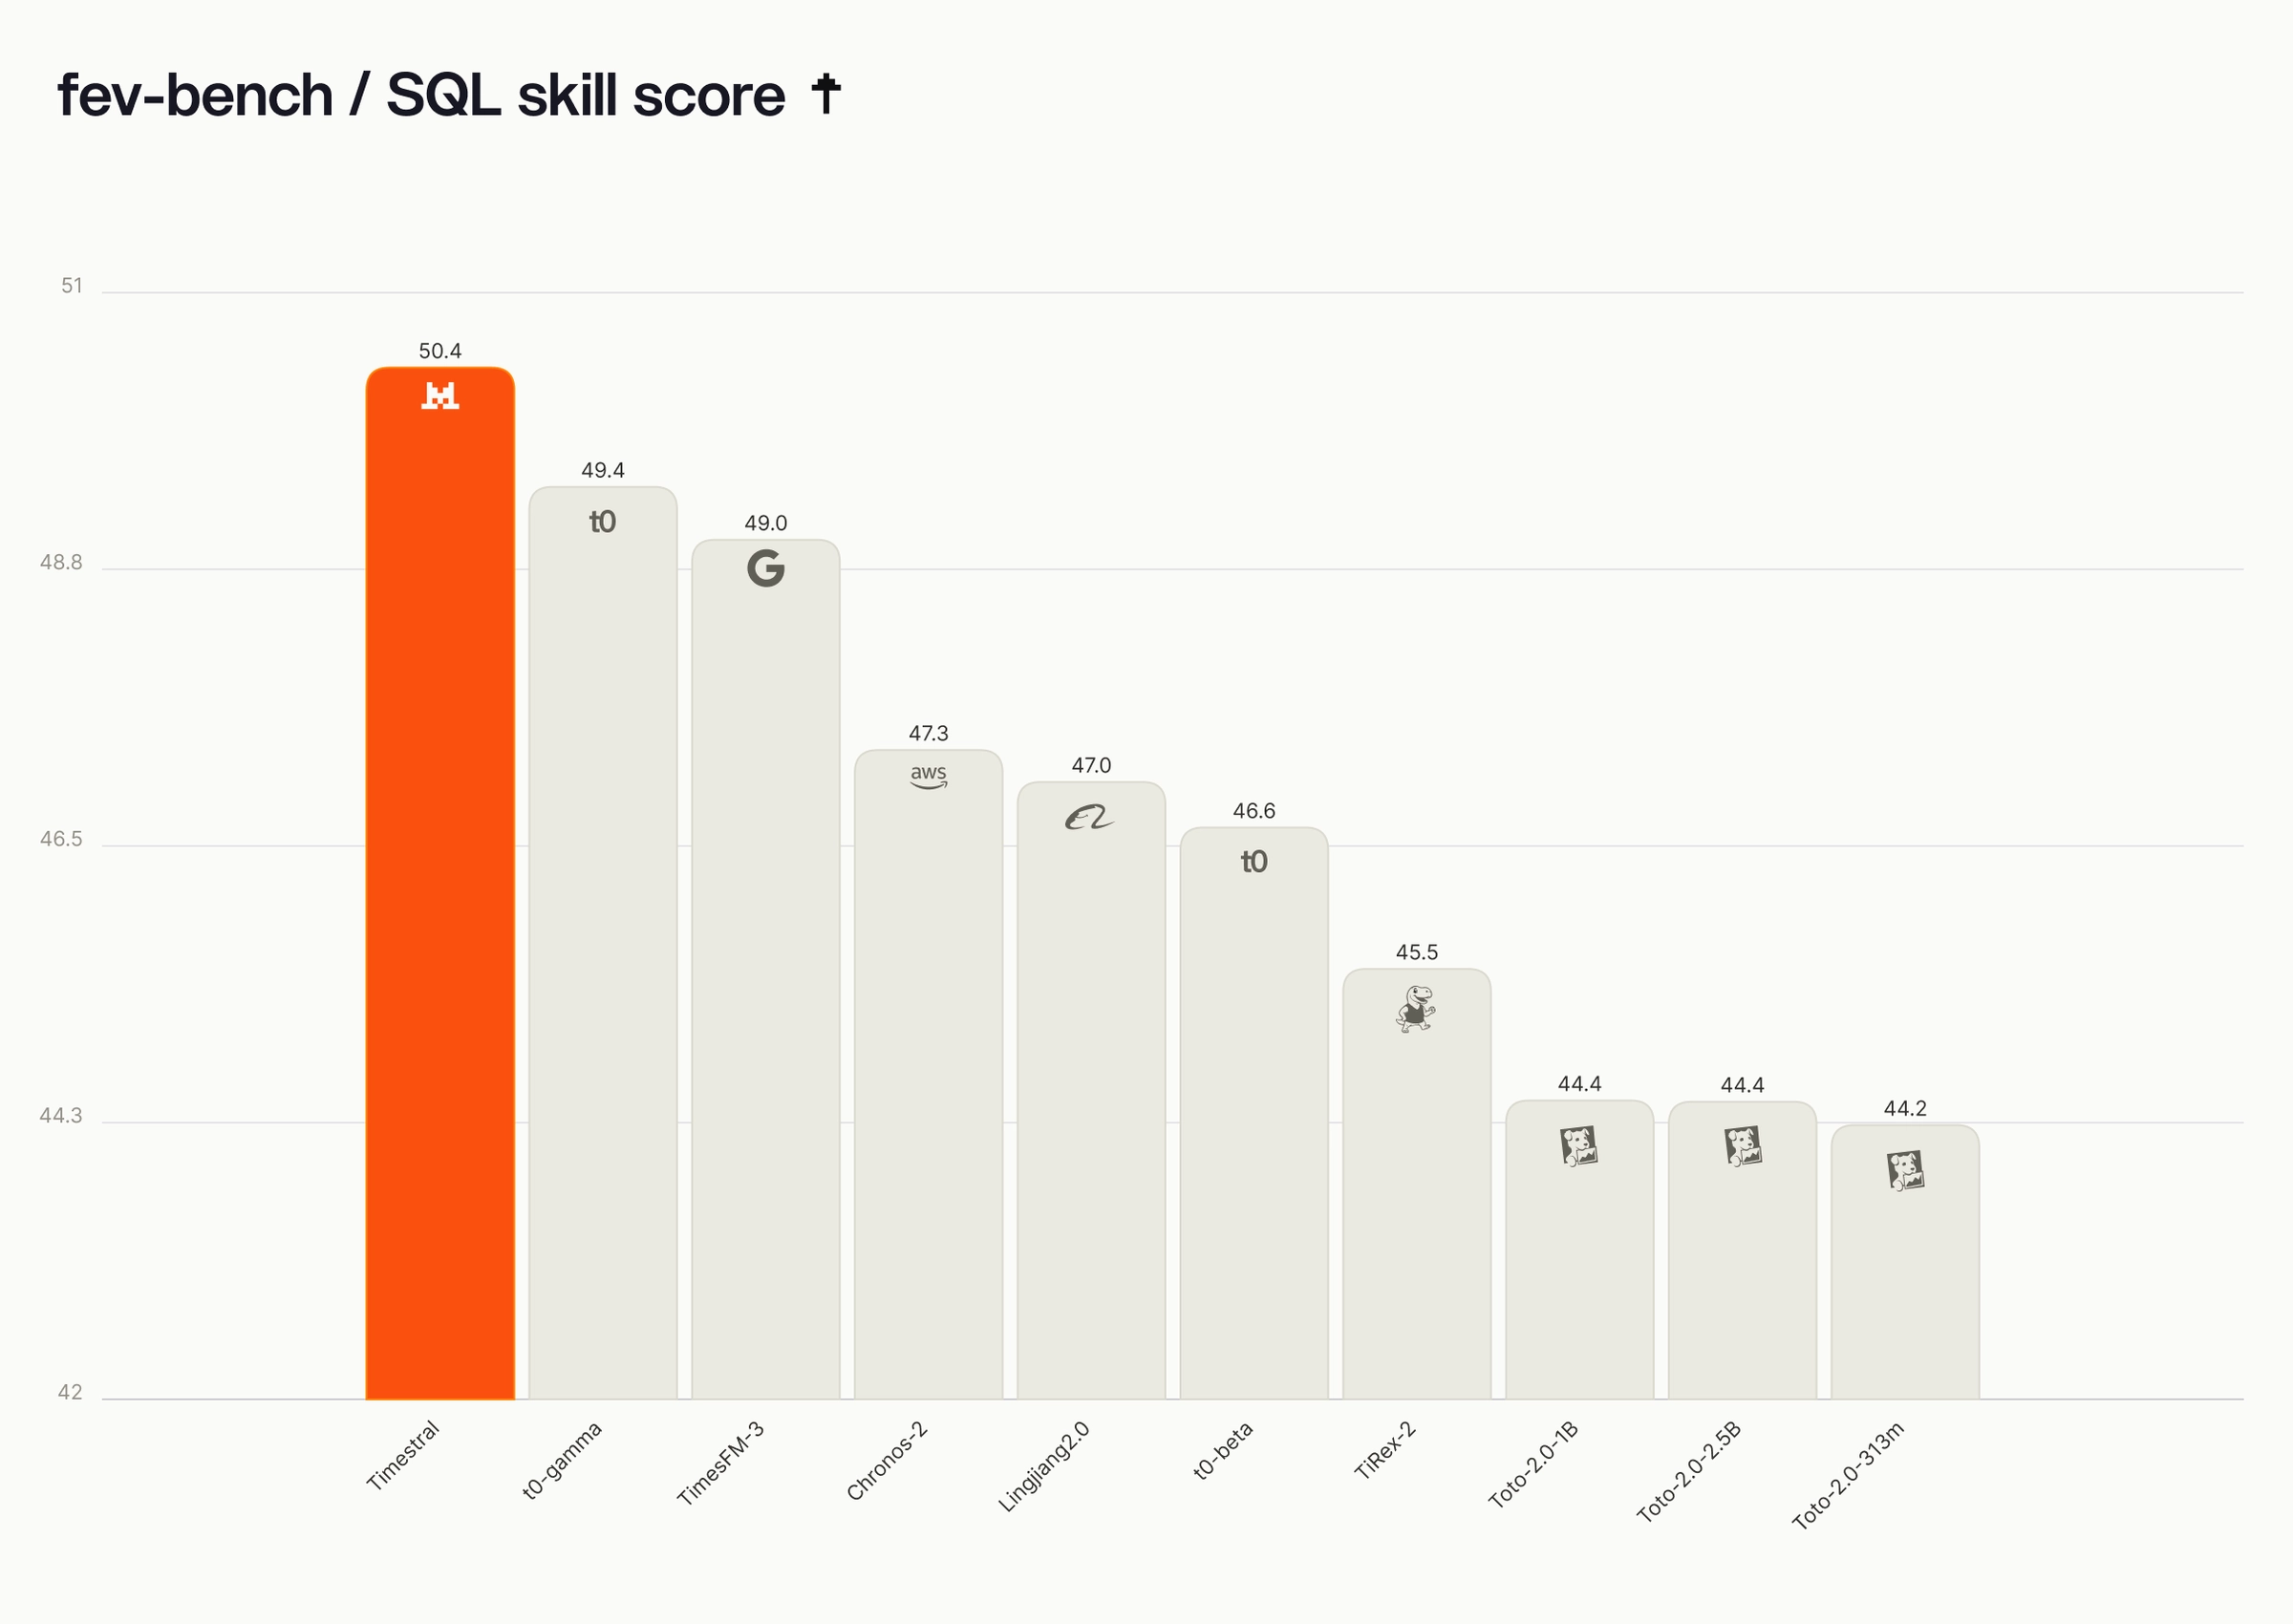
fev-bench, les dix premières des 37 entrées du leaderboard, classées par score de skill SQL. Plus la valeur est haute, mieux c'est.
Une famille de modèles optimisée pour chaque besoin
Timestral a été optimisé sous la forme d'une famille de quatre modèles : 5M, 28M, 123M et 209M de paramètres. Les plus grands améliorent la performance des prévisions, tandis que les plus petits sont plus rapides et moins coûteux. Les quatre partagent la même architecture et le même protocole d'entraînement. Chaque taille se situe sur le front de Pareto entre précision et taille de modèle : pour chaque taille, aucun modèle public ne produit de meilleures prévisions.
Score en fonction de la taille du modèle sur GIFT-Eval, TIME et fev-bench (affiché sous forme de 1 − skill score). Plus la valeur est basse, mieux c'est. Notre modèle 28M devance Chronos-2, environ quatre fois plus grand, sur GIFT-Eval et TIME. Notre modèle 209M bat TimesFM-3 et Falcon-2.0 avec moins de paramètres.
Timestral n'a pas besoin de GPU pour l'inférence. Sur un CPU de serveur standard avec 8 threads, prévoir une journée à partir de trois semaines d'historique au pas de 15 minutes prend 10 ms avec le modèle 5M et 140 ms avec le modèle 209M. Les modèles plus petits échangent un peu de précision contre de la vitesse : le modèle 28M est cinq fois plus rapide que le modèle 209M, et le modèle 123M obtient un score à moins de 0,2 % de celui du 209M avec les trois quarts de sa latence.
Un exemple industriel
Prenons une usine dotée de milliers de capteurs répartis sur ses équipements. Timestral peut améliorer les prévisions sur ces données de plusieurs manières.
Prévision multivariée. La vibration, la température et la pression d'une pompe ne varient pas indépendamment les unes des autres. Une hausse de l'une explique ou provoque souvent un changement dans une autre. Timestral modélise les séries liées conjointement, ce qui lui permet d'utiliser ces dépendances au lieu de prévoir chaque capteur isolément.
Prévision probabiliste. Une seule valeur prédite ne montre pas toujours l'ensemble du tableau. Timestral prédit un ensemble complet de quantiles, ce qui permet aux équipes de mesurer l'ampleur de l'incertitude, de fixer des seuils d'alerte qui en tiennent compte et de planifier la maintenance en fonction du risque plutôt que d'un seul chiffre.
Covariables catégorielles. Certaines covariables prennent leurs valeurs dans un ensemble de catégories plutôt que dans des nombres continus, comme le jour de la semaine ou l'état d'une machine (en marche, à l'arrêt, en maintenance). Les encoder sous forme de nombres leur imposerait un ordre ou une échelle qu'elles n'ont pas. Timestral les prend directement en entrées catégorielles pour améliorer les prévisions.
Covariables à futur connu. Certains facteurs qui influencent le comportement des capteurs sont connus à l'avance : programmes de production, arrêts planifiés, prévisions météo. Timestral peut conditionner ses prévisions sur ces variables pour en améliorer la qualité, si bien qu'une augmentation de charge planifiée est anticipée plutôt que signalée comme une anomalie.
Du modèle au système
Timestral est un modèle numérique qui peut s'exécuter au sein de pipelines de monitoring existants ou être associé à nos modèles de langage dans des workflows agentiques multimodaux.
Dans l'usine, cela pourrait prendre la forme suivante :
Timestral s'exécute en continu sur les flux de capteurs de l'usine et détecte les anomalies dès qu'elles surviennent.
Quand il signale une anomalie sur une pompe, un agent transforme les signaux en embeddings et les compare aux embeddings des données de capteurs passées pour retrouver des défaillances historiques similaires.
L'agent lance ensuite des sous-agents pour mener une analyse des causes racines, en s'appuyant sur le contexte de l'usine : registres de maintenance, journaux de poste et notes des opérateurs, manuels des équipements, ordres de travail passés et relevés des équipements liés.
À partir de ces constats, l'agent propose un diagnostic, accompagné d'éléments de preuve et de pistes d'action possibles.
Le responsable de l'usine obtient un diagnostic et un plan étayés par les données des capteurs, et non une simple alerte.
Principales contributions techniques
Plusieurs idées ont été combinées pour produire ces résultats. Chacune sera décrite en détail dans le rapport technique.
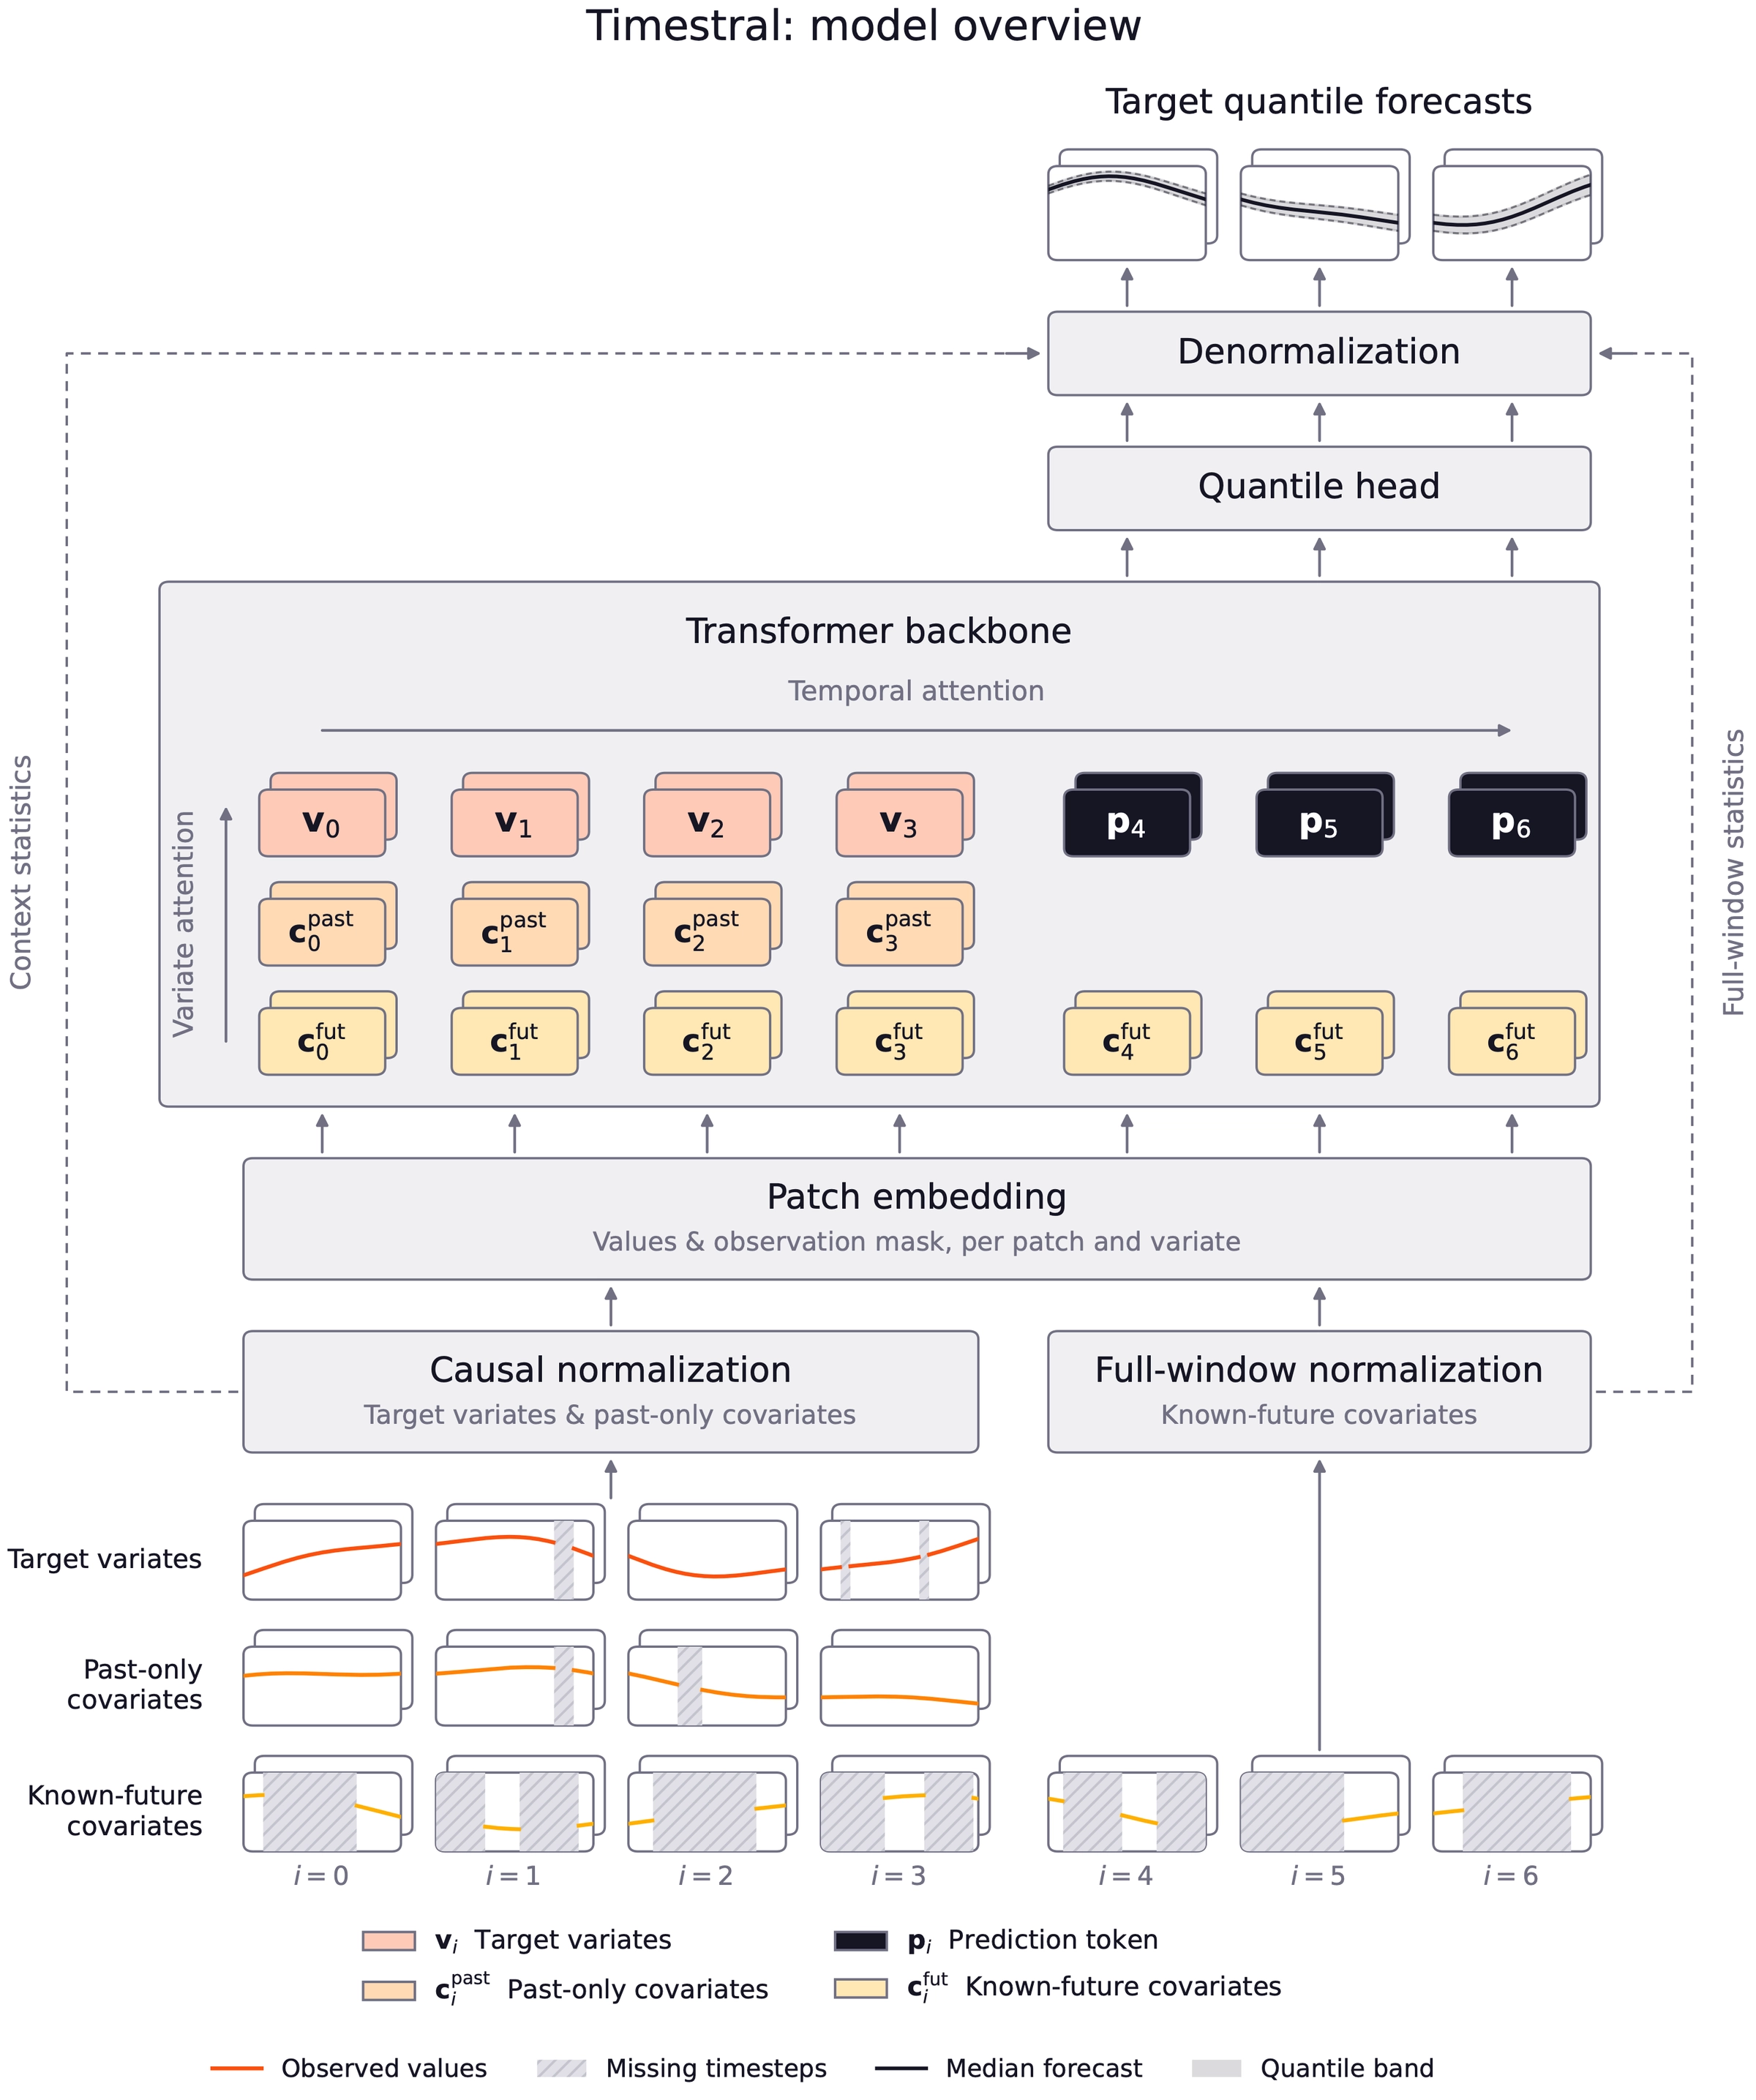
Prévision à horizon découplé. Les décodeurs causaux entraînés avec un masquage de patchs contigus, comme dans Toto 2.0 et TimesFM-3, masquent les valeurs à prévoir, qui ressemblent alors à des valeurs manquantes et sont également perdues en tant que contexte pour les prévisions ultérieures. Notre approche, DHF, sépare les deux : l'historique complet reste dans la séquence et des tokens de prévision appris lisent l'historique qui les précède. Chaque valeur observée sert ainsi à la fois de cible et de contexte, les vraies lacunes restent marquées comme manquantes, et les longueurs d'horizon d'entraînement et l'augmentation de données manquantes peuvent être ajustées indépendamment l'une de l'autre.
Attention sensible aux covariables. Chaque série d'entrée se voit attribuer un rôle : variable cible, covariable passée uniquement ou covariable à futur connu. Les covariables à futur connu sont visibles sur toute la fenêtre, tandis que les cibles restent causales, et l'information ne circule que des covariables vers les cibles. Timestral peut ainsi utiliser un calendrier de jours fériés ou une prévision météo sans que le futur d'une cible ne fuie dans sa propre prévision.
Données synthétiques avant tout. La majorité des données d'entraînement étaient synthétiques. Nous avons d'abord généré des processus univariés à la dynamique temporelle cohérente, incluant des tendances, de la saisonnalité et divers motifs de bruit. Nous avons ensuite utilisé un synthétiseur multivarié pour construire des séries multivariées en introduisant des dépendances non linéaires entre ces processus.
Entraînement en deux étapes. Timestral est d'abord préentraîné à grande échelle sur des données purement synthétiques avec une taille de contexte de 8192, puis post-entraîné sur un mélange de données réelles et synthétiques avec un contexte quatre fois plus long. L'objectif est une perte pinball sur 21 quantiles, une approximation discrète du CRPS.
Un modèle adaptable
Les benchmarks publics mesurent la performance générale, mais les données de production peuvent présenter des comportements et des structures sensiblement différents. Elles peuvent aussi évoluer dans le temps, à mesure que les marchés changent de régime, que les équipements se dégradent et que les schémas de demande se déplacent. La valeur durable réside dans la capacité à adapter un modèle aux données du domaine et à le réentraîner au fil de l'évolution de la distribution.
Pour les organisations qui veulent aller plus loin, Timestral est disponible via Mistral Forge, le même pipeline d'entraînement que nous utilisons pour nos modèles de langage. Il prend en charge :
Inférence zero-shot prête à l'emploi.
Extensions architecturales, comme des covariables spécifiques au domaine.
Fine-tuning sur données propriétaires, pour se spécialiser dans un domaine tout en préservant la performance générale.
Contrôle des données d'entraînement, y compris l'ajustement du mélange d'entraînement, la réutilisation des données de préentraînement et la génération d'échantillons de données synthétiques pour refléter le domaine cible. Le contrôle total des données garantit qu'aucune donnée utilisée pour le backtest n'a été vue pendant le préentraînement.
Le pipeline complet peut être déployé sur le matériel de nos clients, y compris dans des environnements air-gapped.
Et maintenant
Nous avons publié un dépôt GitHub pour que vous puissiez exécuter Timestral sur vos propres données. Un rapport technique avec les résultats complets suivra. Pour des problèmes de prévision plus spécialisés, ou pour collaborer avec nous sur la recherche, n'hésitez pas à nous contacter.
Timestral | |
|---|---|
Type | Modèle de fondation pour séries temporelles (TSFM) |
Paramètres | 5M, 28M, 123M et 209M |
Longueur de contexte | 32 768 pas de temps |
Sortie | Prévisions probabilistes, 21 quantiles |
Entrées | Cibles multivariées, covariables passées uniquement et à futur connu |
Déploiement | Sur site, VPC ou air-gapped |
Licence | MIT modifiée |